 物联网心球
大家好,这里是物联网心球。
本期文章,我们来深入学习 Linux cgroup。
1.cgroup 是什么?
cgroup(Control Groups)是 Linux 内核提供的一种机制,用于限制、记录和隔离进程组使用的物理资源(CPU、内存、磁盘 I/O 等)。它是容器技术(Docker、Kubernetes)实现资源隔离的底层基石。
cgroup 的核心设计目标是:让系统管理员能够对一组进程进行资源管控,而不需要修改应用程序代码。进程本身感知不到 cgroup 的存在,内核在资源分配时按照 cgroup 规则进行限制。如果 Namespace 解决的是"进程能看到什么"的问题,那么 cgroup 解决的就是"进程能用多少"的问题。
cgroup 的内核实现核心代码位于 kernel/cgroup/ 目录。cgroup 与进程之间通过struct css_set 建立关联,每个进程的 task_struct 中有一个指向 css_set 的指针,css_set 中又包含了指向各子系统 CSS 的指针数组 subsys。struct css_set 的简化定义如下:
struct css_set {
    struct cgroup_subsys_state *subsys[CGROUP_SUBSYS_COUNT]; /* 各子系统的 CSS */
struct list_head tasks;
/* 关联的进程链表 */
struct list_head mg_tasks;
/* 迁移中的进程链表 */
    struct cgroup_root *dfl_cgrp; /* 默认 cgroup 根 */
    struct list_head cgrp_links;  /* 关联的 cgroup 链表 */
    struct cgroup_subsys_state *subsys[CGROUP_SUBSYS_COUNT]; /* 子系统 CSS 数组 */
};
多个进程可以共享同一个 css_set,表示它们属于相同的 cgroup 组合。当进程加入新的 cgroup 时,内核会查找或创建匹配的 css_set,然后更新进程的 css_set 指针。
每个 cgroup 与每个子系统之间都关联一个 CSS(struct cgroup_subsys_state)对象,它建立了 cgroup 和子系统之间的桥梁,其定义如下:
struct cgroup_subsys_state {
struct cgroup *cgroup;
/* 指向所属的 cgroup */
struct cgroup_subsys *ss;
/* 指向所属的子系统 */
struct list_head sibling;
/* 兄弟节点链表 */
struct list_head children;
/* 子节点链表 */
int id;
/* CSS ID */
unsigned int serial_nr;
/* 序列号 */
};
cgroup 本身的数据结构 struct cgroup 定义如下(简化版):
struct cgroup {
struct cgroup_root *root;
/* 指向 cgroup 根 */
    struct cgroup_subsys_state self;/* 自身的 CSS */
    struct cgroup_subsys_state __rcu *subsys[CGROUP_SUBSYS_COUNT]; /* 各子系统的 CSS */
    struct cgroup_file files[CGROUP_FILE_COUNT]; /* 控制文件 */
struct kernfs_node *kn;
/* kernfs 节点 */
};
cgroup 通过 self 的parent、children、sibling 构成了树形结构,通过 subsys 数组与各子系统关联。每个子系统通过 struct cgroup_subsys 描述,它定义了子系统的名称、ID、初始化函数、控制文件注册函数等:
struct cgroup_subsys {
const char *name;
/* 子系统名称 */
unsigned int id;
/* 子系统 ID */
    struct cgroup_subsys_state *(*css_alloc)(struct cgroup_subsys_state *parent_css);
    int (*css_online)(struct cgroup_subsys_state *css);
    void (*css_offline)(struct cgroup_subsys_state *css);
    void (*css_free)(struct cgroup_subsys_state *css);
struct cftype *dfl_cftypes;
/* v2 控制文件定义 */
    struct cftype *legacy_cftypes; /* v1 控制文件定义 */
bool threaded;
/* 是否支持线程模式 */
};
cgroup 的核心能力包括:限制(Limit,限制资源上限)、优先级(Prioritize,按权重分配)、记录(Account,统计使用量)、控制(Control,挂起/恢复进程组)。
这些能力通过子系统实现,每个子系统负责一类资源。常用的子系统有 cpu(CPU 时间分配)、memory(内存使用量)、io(磁盘 I/O 带宽)、pids(进程数量)、cpuset(CPU 核心绑定)等。
cgroup 的初始化在内核启动阶段完成。start_kernel 函数调用 cgroup_init 函数,该函数注册 cgroup 文件系统类型并初始化各子系统。每个子系统通过 cgroup_subsys_init 宏在编译时注册到 cgroup_subsys[] 数组中,内核启动时依次调用各子系统的 css_alloc 和 css_online 回调函数完成初始化。当用户空间创建 cgroup 目录时,内核通过 cgroup_mkdir 函数处理,该函数分配新的 struct cgroup 结构,初始化各子系统的 CSS,然后在 kernfs 中创建对应的目录节点。
2.cgroup 文件系统
cgroup 通过虚拟文件系统 cgroupfs 暴露所有管理接口。cgroupfs 不是磁盘文件系统,而是一个基于 kernfs 的内存文件系统。cgroup v2 文件系统类型定义如下:
static struct file_system_type cgroup2_fs_type = {
    .name            = "cgroup2",
    .init_fs_context = cgroup_init_fs_context,
    .parameters      = cgroup2_fs_parameters,
    .kill_sb         = cgroup_kill_sb,
    .fs_flags        = FS_USERNS_MOUNT,
};
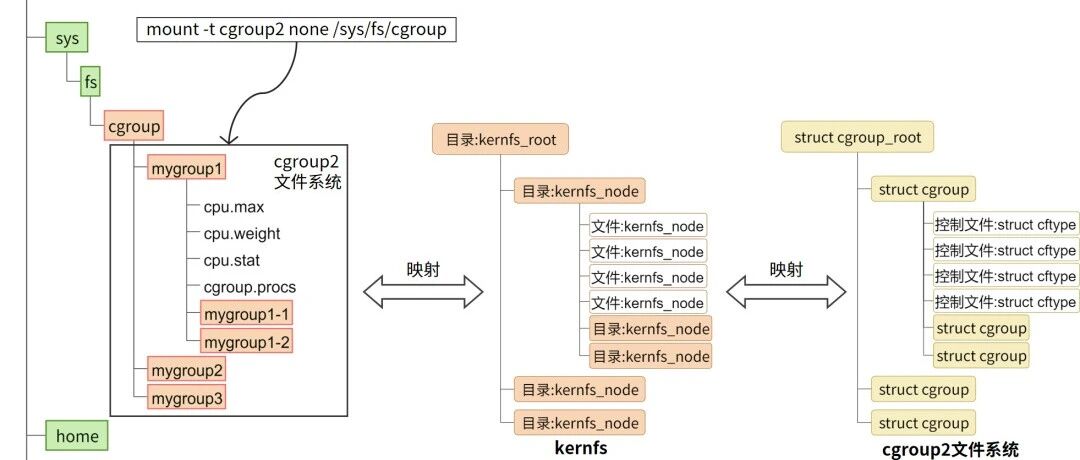
cgroup 文件系统总览如图1所示。

图1 cgroup 文件系统总览
cgroup v2 挂载在 /sys/fs/cgroup 路径下。cgroupfs 的核心设计理念是:目录即 cgroup,文件即控制接口 。创建 cgroup 只需 mkdir,删除只需 rmdir,配置限制只需 echo 写入控制文件,查看使用情况只需 cat 读取控制文件。
kernfs 是 cgroupfs 的底层实现。kernfs 是 Linux 内核中专门为内核子系统提供文件系统支持的框架,它简化了虚拟文件系统的创建过程。cgroup 中的每个目录和文件在 kernfs 中都对应一个 struct kernfs_node 节点。当用户程序访问 cgroup 文件时,kernfs 负责将 VFS(虚拟文件系统)的调用路由到 cgroup 子系统的回调函数。
cgroupfs 中的控制文件分为两类:通用文件(所有 cgroup 都有,以 cgroup. 为前缀)和子系统文件(取决于启用的控制器)。通用文件主要有:
cgroup.procs:cgroup 中的进程 PID 列表。cgroup.controllers:该 cgroup 可用的控制器列表。cgroup.subtree_control:控制子 cgroup 启用哪些控制器。cgroup.events:通知事件。cgroup.stat:cgroup 统计信息。
以 memory 子系统为例,其主要控制文件有:
memory.max:硬限制,超过后触发 OOM。memory.high:软限制,超过后内核开始积极回收内存。memory.low:软保护,保证最低可用内存。memory.current:当前内存使用量(只读)。memory.events:事件计数器(oom、oom_kill、high、max 等)。memory.oom.group:是否将整个 cgroup 作为 OOM 单元。
cgroup 控制文件的内核实现基于 struct cftype(cgroup file type)。struct cftype 定义了控制文件的名称、权限、读写回调函数等,其简化定义如下:
struct cftype {
char name[MAX_CFTYPE_NAME];
/* 文件名 */
unsigned long flags;
/* 标志位 */
unsigned int max_write_len;
/* 最大写入长度 */
struct cgroup_subsys *ss;
/* 所属子系统 */
struct list_head node;
/* 链表节点 */

    /* 读回调:用户程序执行 cat 时调用 */
    int (*seq_show)(struct seq_file *sf, void *v);

    /* 写回调:用户程序执行 echo 时调用 */
    ssize_t (*write)(struct kernfs_open_file *of,
                     char *buf, size_t nbytes, loff_t off);
};
当用户程序执行 cat /sys/fs/cgroup/myapp/memory.current 时,内核通过 struct cftype 的 seq_show 回调函数读取内存使用数据。当执行 echo 536870912 > memory.max 时,内核通过 write 回调函数设置内存上限。以 memory.max 为例,其 write 回调最终调用 mem_cgroup_write 函数,该函数将写入值设置到 struct mem_cgroup 的 memory.max 成员中。struct mem_cgroup 是 memory 子系统的核心数据结构,它记录了该 cgroup 的所有内存使用状态和限制参数。后续每次内存分配时,内核都会检查该 cgroup 的累计内存是否超限。一旦超限,内核会触发 OOM Killer 或直接触发内存回收。
CPU 子系统则与 CFS(完全公平调度器)深度集成。cpu.max 的格式是"配额 周期",例如 100000 100000 表示每 100ms 的周期内最多使用 100ms 的 CPU 时间(即 1 核)。其内核实现通过 struct cfs_bandwidth 结构管理配额和周期。当配额耗尽时,调度器调用 throttle_cfs_rq 函数将该 cgroup 内进程的 CFS 运行队列挂起(throttle),直到下一个周期开始时调用 unthrottle_cfs_rq 恢复。这就是容器中 CPU 限流的根本原因。cpu.stat 文件中的 nr_throttled 字段记录了被限流的周期数,throttled_usec 字段记录了累计限流时间,这两个指标是排查 CPU 限流问题的关键依据。
来看一个完整的操作示例:
# 1. 创建 cgroup
mkdir /sys/fs/cgroup/myapp

# 2. 设置 CPU 限制:每 100ms 周期内最多 100ms(即 1 核)
echo "100000 100000" > /sys/fs/cgroup/myapp/cpu.max

# 3. 设置内存硬限制:512MB
echo 536870912 > /sys/fs/cgroup/myapp/memory.max

# 4. 设置内存软限制:400MB
echo 419430400 > /sys/fs/cgroup/myapp/memory.high

# 5. 限制最多 200 个进程
echo 200 > /sys/fs/cgroup/myapp/pids.max

# 6. 将进程(PID 12345)加入 cgroup
echo 12345 > /sys/fs/cgroup/myapp/cgroup.procs

# 7. 查看资源使用情况
cat /sys/fs/cgroup/myapp/memory.current
cat /sys/fs/cgroup/myapp/memory.events
cat /sys/fs/cgroup/myapp/cpu.stat
3.cgroup 树形结构
cgroup 通过 struct cgroup 中的 parent、children、sibling 成员构成了树形层次结构。根节点是 /sys/fs/cgroup,代表整个系统的根 cgroup。子 cgroup 继承父 cgroup 的资源限制,子 cgroup 的资源使用量不能超过父 cgroup 的上限。cgroup 树形结构如下:
/sys/fs/cgroup/                    # 根 cgroup(系统全部资源)
├── kubepods.slice/                # K8s 所有 Pod:12核 24GB
│   ├── pod-aaa.slice/             # Pod A:2核 4GB
│   │   ├── container1/            # 容器1:1核 2GB
│   │   └── container2/            # 容器2:1核 2GB
│   └── pod-bbb.slice/             # Pod B:4核 8GB
│       └── container3/            # 容器3:4核 8GB
├── system.slice/                  # 系统服务:2核 4GB
└── kubelet.service/               # kubelet:2核 4GB
根 cgroup 拥有全部资源,kubepods.slice 从根分到 12 核 24GB,Pod A 从 kubepods 分到 2 核 4GB,容器1和容器2再从 Pod A 各分到 1 核 2GB。每一层的分配总和不超过父层级限额。
cgroup 树的核心特性是资源继承。内核在处理 cgroup 层级关系时,通过 cgroup_parent()等函数实现层级遍历和继承检查。当子 cgroup 设置资源限制时,内核会检查该限制是否超过父 cgroup 的上限。以 memory.max 为例,子 cgroup 的 memory.max 不能超过父 cgroup 的 memory.max。如果父 cgroup 的内存上限为 512MB,子 cgroup 最多也只能设置为 512MB,不能超过这个值。
在 cgroup v2 中,控制器需要在父层级通过 cgroup.subtree_control 显式启用,子 cgroup 才能使用对应的控制文件,操作示例如下:
# 在 myapp 下创建子 cgroup
mkdir /sys/fs/cgroup/myapp/worker

# 为子 cgroup 启用 cpu 和 memory 控制器
echo "+cpu +memory" > /sys/fs/cgroup/myapp/cgroup.subtree_control

# 子 cgroup 在父 cgroup 限额内进一步分配
echo "50000 100000" > /sys/fs/cgroup/myapp/worker/cpu.max  # 0.5 核
echo 268435456 > /sys/fs/cgroup/myapp/worker/memory.max    # 256MB

# 将进程加入子 cgroup
echo 12346 > /sys/fs/cgroup/myapp/worker/cgroup.procs
在 cgroup v2 统一层级下,一个进程在任意时刻只属于一个 cgroup。当把进程 PID 写入新 cgroup 的 cgroup.procs 时,内核通过 cgroup_attach_task 函数将进程从原 cgroup 迁移到新 cgroup。该函数首先查找或创建与新 cgroup 匹配的 css_set,然后更新进程 task_struct 中的 css_set 指针,使其指向新的 css_set。迁移完成后,进程的资源使用就会受到新 cgroup 的限制。
4.cgroup v1 和 v2
cgroup 经历了两个大版本:v1 和 v2。
4.1 cgroup v1
cgroup v1 采用"一个子系统一棵树"的架构。CPU、内存、I/O 等各自挂载在独立的层级树上,路径分别为 /sys/fs/cgroup/cpu/、/sys/fs/cgroup/memory/、/sys/fs/cgroup/blkio/ 等。v1 的文件系统类型定义如下:
static struct file_system_type cgroup_fs_type = {
    .name            = "cgroup",
    .init_fs_context = cgroup_init_fs_context,
    .parameters      = cgroup1_fs_parameters,
    .kill_sb         = cgroup_kill_sb,
    .fs_flags        = FS_USERNS_MOUNT,
};
v1 每棵树相互独立,一个进程在每棵树上可以独立归属到不同的 cgroup。这种设计看似灵活但却存在很多问题:
- 层级不一致:不同子系统的 cgroup 树可以完全不同,难以统一管理。
- 接口割裂 :控制文件命名不统一,如
cpu.cfs_quota_us、memory.limit_in_bytes、blkio.throttle.read_bps_device,缺乏一致性。 - 进程归属混乱:一个进程在每棵树上归属不同 cgroup,资源限制的关联关系非常复杂。
- 迁移开销大 :进程在 cgroup 之间移动时需要更新多个
css_set,开销大。
4.2 cgroup v2
cgroup v2 的核心变化是统一层级:所有子系统共享同一棵 cgroup 树,进程只归属于唯一一个 cgroup。
v2 在内核中引入了 struct cgroup_root 来管理统一的 cgroup 层级树:
struct cgroup_root {
struct kernfs_root *kf_root;
/* kernfs 根 */
unsigned int subsys_mask;
/* 启用的子系统掩码 */
int hierarchy_id;
/* 层级 ID */
struct cgroup cgrp;
/* 根 cgroup */
int nr_cgrps;
/* cgroup 总数 */
struct list_head root_list;
/* 全局根链表 */
unsigned int flags;
/* 标志位 */
struct cgroupfs_opts opts;
/* 挂载选项 */
};
struct cgroup_root 管理整个 cgroup 层级树的生命周期。subsys_mask 是一个位掩码,记录了该层级树启用了哪些子系统。cgrp 是根 cgroup,所有其他 cgroup 都是它的后代。整个系统中可以存在多个 cgroup_root,通过 root_list 链表串联,但在 v2 统一层级模式下通常只有一个。
v2 在接口设计上也更加规范:通用控制文件以 cgroup. 为前缀,子系统参数统一为 控制器.参数 格式(如 cpu.max、memory.max、io.max)。这种统一的命名规范大大降低了运维成本。此外,v2 还引入了多项改进:
- 支持线程级粒度控制(
cgroup.threads文件,配合cgroup.type=threaded)。 - 内置
cgroup.stat和cgroup.events监控文件,无需额外工具。 - 通过 BPF 实现设备控制(替代 v1 的
devices子系统),更加灵活。 - 原生支持
memory.high软限制,实现优雅降级——内存使用超过memory.high后内核开始积极回收,避免直接触发 OOM。 - 支持
memory.oom.group,将整个 cgroup 作为 OOM 单元,适用于容器场景。
4.3 v1 与 v2 对比
| 对比维度 | cgroup v1 | cgroup v2 |
|---|---|---|
| 层级结构 | 每个子系统独立树 | 统一层级树 |
| 进程归属 | 每棵树独立归属 | 全局唯一归属 |
| 控制文件命名 | 各子系统风格不统一 | 统一命名规范 |
| 挂载路径 | /sys/fs/cgroup/{cpu,memory,...} | /sys/fs/cgroup(单一挂载点) |
| 内存软限制 | 无直接等价物 | memory.high |
| 文件系统类型名 | cgroup | cgroup2 |
| 内核数据结构 | cgroup_subsys_state 独立管理 | cgroup_root 统一管理 |