 物联网心球
大家好,这里是物联网心球。
最近一直忙着写新书,本文同样是新书的一个小节。本文讨论的是网络编程中一个比较重要概念端口复用。
端口复用,即两个套接字绑定相同的IP和端口。注意这里说的两个套接字指的是两个TCP套接字或两个UDP套接字,而不是一个TCP和一个UDP套接字。TCP和UDP套接字使用的是两套独立的端口体系,二者之间使用相同的IP和端口没有任何冲突。
在进行网络编程时,经常会出现“Address already in use”的错误。错误原因是TCP或UDP套接字尝试绑定已被绑定的端口。简单来说,就是两个套接字绑定相同的IP和端口,第二个套接字将无法绑定该IP和端口。
实际情况,两个套接字很大可能是需要绑定相同IP和端口的,比如,TCP套接字关闭时,如果该TCP套接字处于TIME_WAIT状态,将一直霸占该IP和端口,导致新的TCP套接字无法绑定该IP和端口。另外,一些高性能的服务器(Nginx),通过多进程监听同一端口提升性能,也需要多个套接字绑定相同的IP和端口。
1.SO_REUSEADDR和SO_REUSEPORT选项介绍
SO_REUSEADDR和SO_REUSEPORT是用来实现端口复用的两个套接字选项,按照字面意思理解,SO_REUSEADDR指的是地址复用,SO_REUSEPORT指的是端口复用。学习这两个套接字选项时,我们得纠正一个错误的观念,就是认为二者是两个独立的概念,需要分开来讲解。
SO_REUSEADDR和SO_REUSEPORT具有很强的关联性,必须放在一起来讲解。我们的学习目的不是为了区分二者,而是要理解二者是如何影响端口复用的实现逻辑。
SO_REUSEADDR和SO_REUSEPORT都是属于SOL_SOCKET级别的套接字选项,设置示例代码如下,注意,这两个套接字选项的设置必须在调用bind函数之前:
int on = 1; /* 1:开启;0:关闭 */
setsockopt(sockfd, SOL_SOCKET, SO_REUSEADDR, &on, sizeof(on));
int on1 = 1; /* 1:开启;0:关闭 */
setsockopt(sockfd, SOL_SOCKET, SO_REUSEPORT, &on1, sizeof(on1));
bind(......);
我们来看一下内核实现原理,如图1所示。

图 1 SO_REUSEADDR和SO_REUSEPORT选项内核实现原理
SO_REUSEADDR选项对应的是sock对象的sk_reuse成员,SO_REUSEPORT选项对应的是sock对象的sk_reuseport成员。用户程序调用setsockopt函数并传入0或1来设置sk_reuse和sk_reuseport。实现原理非常简单,这里不再赘述。
UDP和TCP端口复用的逻辑存在差异,我们分开来讲解,首先,我们来看一下UDP如何实现端口复用的。
2.UDP绑定相同IP和端口
UDP绑定相同IP和端口的内核实现原理如图2所示。

图 2 绑定相同IP和端口
Linux内核维护了一个UDP端口号哈希表,该表记录了每个UDP端口号都被哪些套接字绑定了。UDP是否能绑定该IP和端口号,得看哈希表中端口号链表中是否存在与之冲突的套接字。何谓冲突呢?即链表中某个套接字和新套接字的sk_reuse不都为1,且二者sk_reuseport不都为1 。
我们做一个形象的比喻,端口号链表中的套接字就像一些既得利益者,牢牢占据者端口号资源,新套接字想要加入它们的阵营,需要得到所有既得利益者的支持,只要有一个套接字不支持,那么新套接字将无法加入链表。不支持的条件就是二者sk_reuse不都为1,且二者sk_port不都为1。
我们将新套接字是否能绑定相同的IP和端口进行了整理,见表1,注意,新套接字需要和链表中所有的套接字都按照表1进行比较,全部通过后才能绑定成功,新套接字才能加入链表。

表 1 UDP套接字端口复用条件
默认情况,首个套接字的sk_reuse和sk_reuseport都为0,没有开启端口复用,后续所有的套接字不管sk_reuse和sk_useport为多少,都无法绑定相同的IP和端口。
当首个套接字设置了sk_reuse和sk_reuseport后,后续套接字只需要按照表1去设置置sk_reuse和sk_reuseport,就能绑定成功。
我们来看一下内核源码,验证上述逻辑,内核源码中有一个udp_lib_lport_inuse函数,用来判断新的UDP套接字是否能够绑定该IP和端口,非关键代码已经省略,源码如下:
/*
UDP套接字是否可以绑定相同IP和端口判断。
返回0:可以绑定;返回1:不可以绑定
*/
static int udp_lib_lport_inuse(struct net *net, __u16 num,
const struct udp_hslot *hslot,
unsigned long *bitmap,
struct sock *sk, unsigned int log)
{
    struct sock *sk2;
    sk_for_each(sk2, &hslot->head) {
        /* 两个套接字的sk_reuse有一个为0且IP地址相同,条件为真 */
        if ((!sk2->sk_reuse || !sk->sk_reuse) &&
            inet_rcv_saddr_equal(sk, sk2, true)) {
            /* 两个套接字的sk_reuse都为1,条件为真,可以绑定 */
            if (sk2->sk_reuseport && sk->sk_reuseport ) {
                return 0;
            /* 条件为假,不可以绑定 */
            } else {
                return1;
            }
        }
    }
    return 0;
}
至此,UDP套接字绑定相同IP和端口的知识点已经讲解完,大家认真学完上述知识点,就能轻松让你UDP套接字绑定相同的IP和端口了。
前面章节在介绍TCP和UDP套接字调用bind函数绑定源地址时,提到了一个特殊的IP地址INADDR_ANY(0x00000000),INADDR_ANY是绑定本机本机所有IP的意思。那么一个套接字绑定INADDR_ANY和端口,另外一个套接字绑定具体IP和端口,二者之间是否需要符合端口复用逻辑呢?答案是,内核在做端口冲突检测时,会把INADDR_ANY看做是一个具体IP地址,检测逻辑和具体IP一样,这里不需要把INADDR_ANY特殊化。
3.UDP由谁接收数据?
多个UDP套接字绑定了相同IP和端口后,当有数据到来时,该由谁来接收数据呢?我们先不着急回答这个问题,我们先来看UDP接收数据部分的内核实现原理,如图3所示。

图 3 多个UDP套接字接收数据内核实现原理
当一个UDP数据报从网卡接收至内核网络协议栈时,需要根据UDP数据报的目的IP和目的端口匹配UDP套接字,再将UDP数据报存储至UDP套接字接收缓冲区。开启端口复用后,多个UDP套接字会绑定相同的IP和端口,这些套接字都能够接收数据,但最终只能由一个套接字来接收数据。
内核通过积分制来选择最终的套接字,套接字绑定的源IP和源端口和UDP数据报的目的IP和目的端口相同是入围条件,注意,这里先不讨论特殊IP地址INADDR_ANY。然后,以下情况分别会有对应的积分:
- 目的IP匹配加4分:套接字绑定的目的IP和UDP数据报的源IP匹配。
- 目的端口匹配加4分:套接字绑定的目的端口和UDP数据报的源端口匹配。
- 网络接口相同加4分:套接字绑定的网络接口和UDP数据包接收的网络接口相同。
- CPU缓存命中加1分:套接字上次接收数据时被调度的CPU和本次被调度的CPU相同。
最后,最高分的套接字将被选中来接收数据。值得注意的是,UDP套接字如果不通过connect绑定目的IP和目的端口,将无法获取到前两种情况的积分,如果另外一个套接字调绑定了目的IP和目的端口,那么它的积分会一直高于前者,将一直由它来接收数据。所以UDP套接字一旦调用connect函数绑定了目的IP和目的端口,就能优先接收数据,这也是前面节中实现自定义UDP accept函数的基础。
选择由哪个套接字接收数据不是固定的。影响套接字积分有很多条件,有一些条件是动态变化的,内核会根据套接字积分的变换,动态地将数据导入不同的套接字,这样就实现了负载均衡。用户程序启动多个线程或进程来监听相同的IP和端口,多个线程的处理效率会高于单个线程或进程。
前面我们提到过特殊的IP地址INADDR_ANY,如果两个UDP套接字分别绑定了INADDR_ANY和具体IP,接收数据时,该如何匹配套接字呢?答案是具体IP的优先级高于INADDR_ANY ,只有具体IP匹配失败后,才会去匹配INADDR_ANY。INADDR_ANY不会和具体IP放在一起去比分,二者是单独进行比分的,先比较具体IP,再比较INADDR_ANY。
我们来看一下内核源码,如下。
/*
    UDP套接字匹配函数
*/
struct sock *__udp4_lib_lookup(struct net *net, __be32 saddr,
__be16 sport, __be32 daddr, __be16 dport, int dif,
int sdif, struct udp_table *udptable, struct sk_buff *skb)
{
    ......
    hash2 = ipv4_portaddr_hash(net, daddr, hnum);
    slot2 = hash2 & udptable->mask;
    hslot2 = &udptable->hash2[slot2];

    /* 具体IP进行比分 */
    result = udp4_lib_lookup2(net,saddr,sport,daddr,hnum,
                              dif,sdif,hslot2,skb);

    /* 具体IP匹配成功,且套接字绑定了目的地址,跳转至done*/
    if (!IS_ERR_OR_NULL(result) && result->sk_state ==
        TCP_ESTABLISHED)
        goto done;

    /* 具体IP匹配成功,跳转至done */
    if (result)
        goto done;

    hash2 = ipv4_portaddr_hash(net, htonl(INADDR_ANY), hnum);
    slot2 = hash2 & udptable->mask;
    hslot2 = &udptable->hash2[slot2];

    /* INADDR_ANY进行比分 */
    result = udp4_lib_lookup2(net, saddr, sport,
    htonl(INADDR_ANY), hnum, dif, sdif, hslot2, skb);

done:
    if (IS_ERR(result))
         returnNULL;
    return result;
}
4.TCP绑定相同IP和端口
TCP绑定相同IP和端口的逻辑和UDP基本相同,我们可以参考图9-6来理解。新TCP套接字要绑定相同IP和端口同样需要和端口号链表中的套接字一一进行比较,只要和其中一个套接字有冲突,那么就无法绑定成功。TCP判断两个套接字是否有冲突和UDP有差异,可以总结为:两个套接字的sk_reuseport不都为1,则表示二者冲突。不管两个套接字的sk_reuse为多少,我们只要对sk_reuseport进行判断即可。
INADDR_ANY的判断和UDP基本相同,这里不再赘述。
5.TCP由谁接收数据?
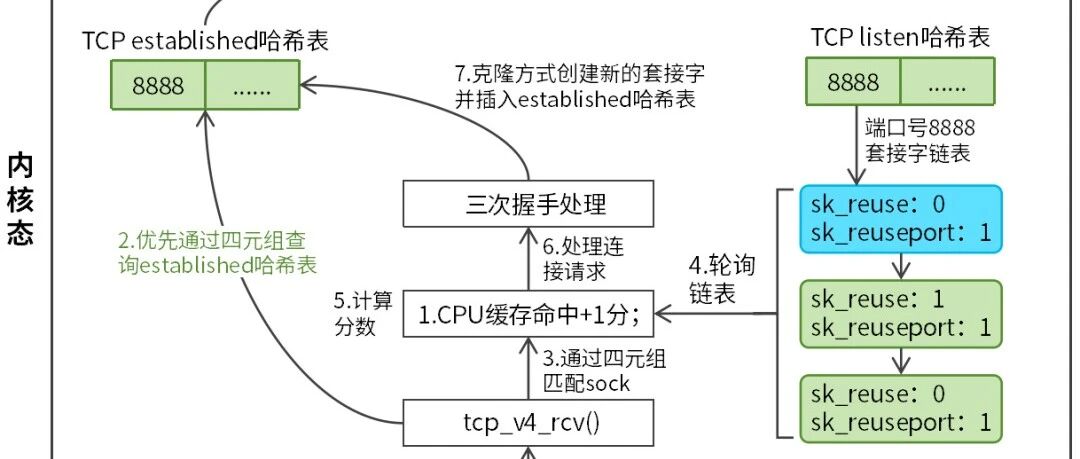
TCP是面相连接的协议,由谁来接收数据其实很简单,只有建立连接的两个套接字才能交互数据。但是,建立连接的过程,则需要匹配套接字。比如,两个TCP服务端程序绑定相同的IP和端口,三次握手环节,客户端的连接请求需要匹配正确的套接字处理。
如图4所示,当一个TCP数据段通过网卡接收至内核时,内核会优先去查询established哈希表(存储已建立连接的套接字),如果在该哈希表中查找到匹配的套接字(四元组相同),那么将由该套接字来接收数据。需要注意的是,从established哈希表中只会查找到一个匹配的套接字,因为一个套接字不能和多个套接字同时建立连接。

图 4 多个TCP套接字接收数据内核实现原理
如果查询established哈希表失败,那么接下来会去查询listen哈希表。服务端程序调用listen函数,会将TCP套接字插入listen哈希表。 TCP服务端如果开启端口复用,那么listen哈希表中将有多个套接字和TCP数据报四元组匹配。
那么,该由谁来接收数据呢?TCP同样采用积分制来决定由谁接收数据,TCP的积分制非常简单,只有一个加分条件:CPU缓存命中加1分。积分最高的TCP套接字将来处理此次TCP连接请求,并和客户端完成三次握手。三次握手成功后,会创建一个新的TCP套接字(已建立连接)插入TCP established哈希表。