 物联网心球
大家好,这里是物联网心球。今天来聊一聊Linux高性能编程,要实现Linux高性能编程,首先我们要完成的工作是无锁化编程,无锁化编程的核心就是我们今天的主题原子操作。
1.缓存一致性问题?

缓存一致性问题发生在多核处理器中,当多个处理器共享同一主内存时,为了提高数据访问速度,每个处理器都有自己的本地高速缓存。
当处理器修改了缓存中的数据后,如果缓存之间没有得到正确的同步更新,可能会导致多个处理器看到的数据不一致,从而引发错误。
现代处理器通过缓存一致性协议(MESI)解决缓存一致性问题。
2.原子操作
2.1 什么是原子操作?
原子操作(Atomic Operation)是计算机编程中的一种概念,它指的是在单个处理器执行期间,一组操作被视为不可分割的整体,要么全部完成,要么全部不执行。
这些操作不会被其他并发线程或中断所打断,因此保证了数据的一致性和完整性,特别是在多线程和并发环境下特别重要。
原子操作的特点包括:
封装性:操作内部的细节对外部不可见,保证了操作的可见性和顺序一致性。
隔离性:在同一时间点内,只有单个线程能够执行原子操作,避免了竞态条件(race condition)。
原子性:即使在并发环境中,整个操作也表现为不可分割的单位。
常见的原子操作包括读取/写入操作(如 CAS, compare-and-swap)、自旋锁、递增/递减计数等。
在多核处理器和现代硬件支持下,一些操作可以自然地被硬件实现为原子操作,但在没有这些支持的语言或平台上,程序员可能需要使用锁或其他同步机制来模拟原子操作。
2.2 原子操作实现原理
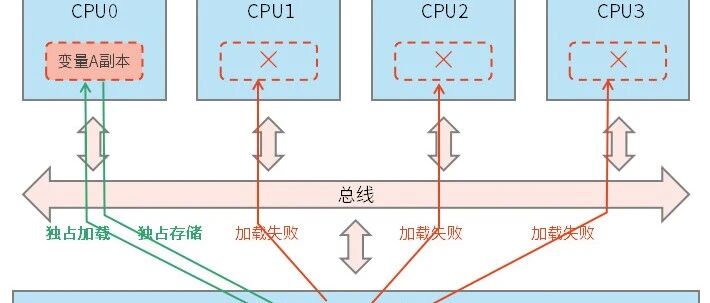
多个线程同时访问内存中一个变量,未使用原子操作的线程,将会并行访问同一个变量,造成缓存一致性问题,从而导致程序逻辑出现问题。

多个线程采用原子操作的方式访问内存中变量,原子操作通常是独占加载和独占存储,在一个原子操作执行期间,其他的线程无法访问内存中同一变量,这样避免了缓存不一致性问题,原子操作将并行访问变成串行访问。

原子操作的实现需要硬件的配合,实现原理也很复杂,我们一定得清楚原子操作解决的是什么问题,才能更好的使用原子操作。
3.原子操作编程
3.1 C语言原子操作
C11标准中引入原子操作,实现了一整套完整的原子操作接口,定义在头文件<stdatomic.h>,C++语言是在C++11标准中引入原子操作,定义在头文件<atomic>,这里我们讨论的是C语言原子操作。
3.1.1 原子变量
原子变量是一种特殊的数据类型,原子操作访问的对象是原子变量。原子变量定义方式:atomic_数据类型变量名。
typedef _Atomic(bool) atomic_bool;
typedef _Atomic(char) atomic_char;
typedef _Atomic(signed char) atomic_schar;
typedef _Atomic(unsigned char) atomic_uchar;
typedef _Atomic(short) atomic_short;
typedef _Atomic(unsigned short) atomic_ushort;
typedef _Atomic(int) atomic_int;
typedef _Atomic(unsigned int) atomic_uint;
typedef _Atomic(long) atomic_long;
typedef _Atomic(unsigned long) atomic_ulong;
typedef _Atomic(long long) atomic_llong;
typedef _Atomic(unsigned long long) atomic_ullong;
3.1.2 原子操作
1)原子变量初始化
void atomic_init(obj, val);
atomic_init函数用于初始化原子变量。
obj:原子变量地址。
val:数值。
如:atomic_init(&lock, 1);
2)原子加载和存储
 void atomic_store(object, desired);
void atomic_store_explicit(object, desired, memory_order order);
T atomic_load(object);
T atomic_load_explicit(object, desired, memory_order order);
atomic_store系列函数用于设置原子变量的值。
atomic_load系列函数用于加载原子变量的值,返回原子变量的值。
object:原子变量地址。
desired:数值。
order:内存顺序。
3)原子交换
 T atomic_exchange(object, desired);
T atomic_exchange_explicit(object, desired, memory_order order);
atomic_exchange系列函数用于设置原子变量的值,并返回原子变量旧值。
object:原子变量地址。
desired:数值。
order:内存顺序。
4)原子比较交换 (CAS)
bool atomic_compare_exchange_strong(object, expected, desired);
bool atomic_compare_exchange_strong_explicit(object, expected, desired, memory_order suc, memory_order fail);
bool atomic_compare_exchange_weak(object, expected, desired);
bool atomic_compare_exchange_weak_explicit(object, expected, desired);
atomic_compare_exchange系列函数就是著名的CAS函数,该系列函数功能:
如果原子变量object和expected值相等,把原子变量设置成desired,返回true。
如果原子变量object和expected值不相等,则把expected设置成object,返回false。
weak和strong的区别在于weak系列函数存在一定的误判,需要通过while循环再次判断。
object:原子变量地址。
expected:预期值,需填变量内存地址。
desired:数值。
suc:成功时的内存顺序。
fail:失败时的内存顺序。
5)原子运算
 T atomic_fetch_add(object, operand);
T atomic_fetch_add_explicit(object, operand);
T atomic_fetch_sub(object, operand);
T atomic_fetch_sub_explicit(object, operand);
T atomic_fetch_or(object, operand);
T atomic_fetch_or_explicit(object, operand);
T atomic_fetch_xor(object, operand);
T atomic_fetch_xor_explicit(object, operand);
T atomic_fetch_and(object, operand);
T atomic_fetch_and_explicit(object, operand);
atomic_fetch系列函数用于执行原子变量加,减,或,异或,与操作,返回原子变量之前旧值。
object:原子变量地址。
operand:数值。
order:内存顺序。
3.1.3 内存顺序(Memory Order)
 typedef enum memory_order {
  memory_order_relaxed = __ATOMIC_RELAXED,
  memory_order_consume = __ATOMIC_CONSUME,
  memory_order_acquire = __ATOMIC_ACQUIRE,
  memory_order_release = __ATOMIC_RELEASE,
  memory_order_acq_rel = __ATOMIC_ACQ_REL,
  memory_order_seq_cst = __ATOMIC_SEQ_CST
} memory_order;
memory_order_relaxed:最宽松的顺序,不保证操作的顺序,可能会导致数据竞争(data races)。
memory_order_consume:主要用于无须保持历史状态的读操作,可以优化某些场景下的性能。
memory_order_acquire:确保之前的写操作已经对其他线程可见,但可能重排序。
memory_order_release:确保当前写操作对其他线程立即可见,但之前的读操作可以重排序。
memory_order_acq_rel:同时满足 acquire 和 release,适合于读-修改-写的情况。
memory_order_seq_cst:最严格的顺序,保证操作的顺序与单线程程序一致,包括内存顺序和程序顺序。
4.原子锁
4.1 自定义原子锁
1)原子锁初始化
 atomic_bool atomic_lock; //定义原子锁
atomic_init(&atomic_lock, false); //初始化原子锁
2)原子锁加锁
 bool val = false;//通过CAS指令实现原子锁加锁
while(!atomic_compare_exchange_weak_explicit(&atomic_lock, &val, true, memory_order_acquire, memory_order_relaxed)) {
  val = false;
}
3)原子锁解锁
 //通过store指令设置原子锁的值为false
atomic_store_explicit(&atomic_lock, false, memory_order_release);
4.2 锁性能分析
既然今天讨论的是高性能编程,所以我们得回归到高性能编程的主题,我们来探讨一下无锁,互斥锁,自旋锁,自定义原子锁之间的性能差距。
4.2.1 测试方法
测试代码:
#include <stdio.h>
#include <stdbool.h>
#include <pthread.h>
#include <stdatomic.h>

#define THREAD_NUM (4) //测试线程数量
#define TIMES (50000000LL) //每个线程自增次数

#define LOCK_TYPE (3) //锁类型
#define FREE_LOCK 0 //无锁
#define MUTEX_LOCK 1 //互斥锁
#define SPIN_LOCK 2 //自旋锁
#define ATOMIC_LOCK 3 //自定义原子锁

long long sum = 0;
pthread_mutex_t mutex;
pthread_spinlock_t spinlock;
atomic_bool atomic_lock;

void do_lock() {
#if (LOCK_TYPE == MUTEX_LOCK)
    pthread_mutex_lock(&mutex);
#elif (LOCK_TYPE == SPIN_LOCK)
    pthread_spin_lock(&spinlock);
#elif (LOCK_TYPE == ATOMIC_LOCK)
    bool val = false;
    while(!atomic_compare_exchange_weak_explicit(&atomic_lock, &val, true, memory_order_acquire, memory_order_relaxed)) {
        val = false;
    }
#else
#endif
}

void do_unlock() {
#if (LOCK_TYPE == MUTEX_LOCK)
    pthread_mutex_unlock(&mutex);
#elif (LOCK_TYPE == SPIN_LOCK)
    pthread_spin_unlock(&spinlock);
#elif (LOCK_TYPE == ATOMIC_LOCK)
    atomic_store_explicit(&atomic_lock, false, memory_order_release);
#else
#endif
}

void *test_proc(void *arg) {
    for (long long i = 0; i < TIMES; i++) {
        do_lock();
        sum++;
        do_unlock();
    }
    return NULL;
}

int main(int argc, char *argv[]) {
    pthread_t th[THREAD_NUM];

    pthread_mutex_init(&mutex, NULL);
    pthread_spin_init(&spinlock, 0);
    atomic_init(&atomic_lock, false);

    for (int i = 0; i < THREAD_NUM; i++) {
        pthread_create(&th[i], NULL, test_proc, NULL);
    }

    for (int i = 0; i < THREAD_NUM; i++) {
        pthread_join(th[i], NULL);
    }

    pthread_mutex_destroy(&mutex);
    pthread_spin_destroy(&spinlock);

    printf("sum:%u\n", sum);

    return 0;
}
测试参数:
THREAD_NUM:测试线程数量。
TIMES:每个线程自增次数。
LOCK_TYPE:锁类型。
通过gcc test.c -o test命令将程序编译成可执行程序,然后通过time命令执行程序。

实际时间:程序运行的实际时长。
用户时间:程序在用户态运行的时长。
系统时间:程序在内核态运行的时长。
注意:多核处理器存在用户时间+系统时间 > 实际时间的情况。
4.1.2 测试结果对比
测试硬件环境:树莓派4B,内存4GB。
测试参数:测试线程数量4,每个线程自增次数5千万。
1)锁类型:无锁

线程不加锁的情况,4个线程总的自增次数不是2亿次,测试结果错误,程序运行实际时间只有0.4秒,用户时间和系统时间总共1.6秒。
2)锁类型:互斥锁

线程加互斥锁,4个线程总的自增次数为2亿次,测试结果正确,程序运行实际时间为33.9秒,用户时间和系统时间总共2分06秒。
系统时间为50.3秒,说明互斥锁存在大量的系统调用。
3)锁类型:自旋锁

线程加自旋锁,4个线程总的自增次数为2亿次,测试结果正确,程序运行实际时间为22.8秒,用户时间和系统时间公共1分21秒。
系统时间为0.009秒,说明自旋锁无系统调用。
4)锁类型:自定义原子锁

线程加自定义原子锁,4个线程总的自增次数为2亿次,测试结果正确,程序运行实际时间为21.9秒,用户时间和系统时间公共1分07秒。
系统时间为0.005秒,说明自定义原子锁无系统调用。