 物联网心球
大家好,这里是物联网心球。
本文我们讨论的是协程,协程一直是一个很难理解的概念,今天我们来讨论一下协程,希望通过本文大家能够对协程有更深入的理解。
1.协程简介
理解协程不能仅从程序设计和语法的角度去理解,这样很难学会协程,我们得基于底层实现原理来学习协程,Linux内核其实给我们提供了一个学习协程的模板(Linux线程调度),协程只是在用户层实现了这样一个模板。
1.1 Linux线程调度工作原理

学习协程工作原理之前,我们得首先了解进程和线程的工作原理。这里需要吐槽一个问题,很多资料都喜欢强行去区分进程和线程。
比如说:进程是资源分配的最小单位,线程是资源调度的最小单位。
这种说法实际没有什么意义,因为这种说法脱离了技术实现的历史背景和软件架构。
进程和线程对于内核来说都是一个task_struct对象,没有什么区别,task_struct就是Linux内核调度的单位。
多线程技术未出现时,一个程序就是一个进程,一个进程就是一个task_struct对象,每个task_strcut对象都有独立的代码和数据段等,CPU通过task_struct调度进程。
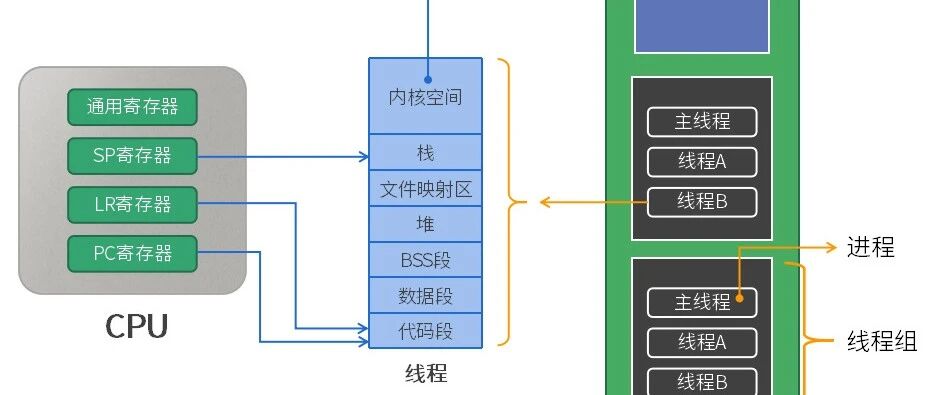
为了提高CPU利用率,多线程技术被发明,有了多线程技术后,进程的概念被弱化,一个程序包含一个线程组,线程组包括主线程和线程。主线程可以理解为进程,主线程和线程都是一个task_struct对象,都能被Linux内核调度,主线程拥有独立的代码和数据段,线程共享主线程代码和数据段。
task_struct对象记录了程序的内存空间,内存空间包括:代码段,数据段,BSS段,堆,文件映射区,栈,内核空间等。
当task_struct对象被CPU选中时,CPU读取内存空间的代码和数据,执行相应的指令。这个就是Linux线程调度的工作原理。
1.2 CPU上下文

了解了Linux线程调度工作原理后,接下来我们需要了解一个非常重要的概念CPU上下文。
学习CPU上下文,我们得站在CPU的角度来学习。
简单来说,CPU工作原理就是取指令,执行指令,返回结果,CPU要执行指令需要借助寄存器,寄存器可以理解为具有特殊功能的小块内存区域,不同体系架构的CPU寄存器也不相同。
( 本文以ARMv8架构CPU来讲解)
CPU有很多寄存器,为了方便讲述知识点,我们只列举几种常用的寄存器:通用寄存器,SP寄存器,LR寄存器,PC寄存器。
通用寄存器:包含31个寄存器,X0-X30,通用寄存器用于保存函数参数,间接计算结果。
LR寄存器:链接寄存器,通用寄存器X30,用于保存子函数返回地址,函数执行完后,跳转至LR寄存器存储的指令地址继续执行。
PC寄存器:程序计数器,CPU当前运行指令的下一条指令地址。
SP寄存器:堆栈指针,SP寄存器和栈一起使用,有局部变量需要入栈和出栈时,通过SP自增和自减来完成。
CPU只知道执行指令,至于代码和数据属于谁并不关心,代码和数据属于谁由Linux内核和编程者关心。

CPU上下文是指当前运行在处理器上的程序的执行状态信息集合,包括寄存器的状态、内存地址、程序计数器(PC)、栈指针等硬件相关的数据。
CPU上下文可以理解为CPU寄存器存储数据的一个快照,Linux内核会把这个快照保存到一个特定的内存区域。
有了CPU上下文的记录,我们想要恢复到代码原来执行的地方,只需要把CPU上下文重置一下CPU寄存器就能完成。
线程调度和切换就是各个线程记录的CPU上下文不断重置CPU寄存器的结果。
1.3 协程
有了前面的背景知识介绍,我们再来理解协程会容易很多。

协程其实就是CPU上下文。
用户通过特定的方法可以在线程执行的过程中,记录线程的CPU上下文,把记录的CPU上下文保存在指定的内存区域,一个线程可以记录多个CPU上下文,通过记录的CPU上下文可以实现程序的跳转,就像调用函数一样。协程的CPU上下文记录是由用户而非Linux内核实现,所以协程也被称为:用户层的轻量级线程。
为什么协程属于线程?
一个线程被CPU选中后,线程会有一个执行时间(时间片),在该时间片内记录的CPU上下文都属于该线程,所以通常会认为协程属于线程。
2.ucontext协程
前面已经学习了协程的一些理论知识,那么我们该如何实现协程呢?
协程的实现的关键是记录CPU上下文,重置CPU寄存器,既然要操作CPU寄存器,最好使用汇编语言。
Linux内核线程调度就是通过汇编语言来实现,对于软件开发人员来说,写出高效且不会出错的汇编语言很有难度。所以我们需要借助第三方工具来实现协程。
今天我们讲的协程方案是ucontext方案,ucontext是GNU C库提供的用于用户态下的CPU上下文切换的方法,定义在ucontext.h头文件。
注意:ucontext方案并不是完美的方案,ucontext方案性能并不是很高,原因在于ucontext方案上下文切换会执行HVC系统调用指令,如果是商业应用可以选择如libco等更高效的方案。
ucontext方案可以帮助我们更好的理解和学习协程。
ucontext总共包含四种方法:
//记录当前CPU上下文至ucp对象
int getcontext(ucontext_t* ucp);

//修改ucp对象任务函数,以及ucp协程返回跳转协程
void makecontext (ucontext_t *ucp, void (*func) (void), int argc, ...);

//切换协程至ucp对象
int setcontext (const ucontext_t *ucp);

//记录当前CPU上下文至oucp对象并切换协程至ucp对象
int swapcontext(ucontext_t *oucp, ucontext_t *ucp);
ucontext_t结构体表示一个CPU上下文信息,定义如下:
typedef struct
{
    unsigned long long int __ctx(fault_address);
    unsigned long long int __ctx(regs)[31];//通用寄存器,regs[30]为LR寄存器
    unsigned long long int __ctx(sp); //SP寄存器
    unsigned long long int __ctx(pc); //任务函数地址
    unsigned long long int __ctx(pstate); //当前处理器状态
    unsigned char __reserved[4096] __attribute__ ((__aligned__ (16)));
} mcontext_t;

typedef struct ucontext_t
{
    unsigned long __ctx(uc_flags);
    struct ucontext_t *uc_link;//协程执行完后,切换的下一个协程
    stack_t uc_stack; //用户自定义栈空间,栈大小
    sigset_t uc_sigmask;
    mcontext_t uc_mcontext; //上下文信息
} ucontext_t;
示例代码:
 #include <ucontext.h>
#include <stdio.h>
#include <unistd.h>

#define STACK_SIZE (8 * 1024)

static ucontext_t uc[3];
char stack1[STACK_SIZE] = {0};
char stack2[STACK_SIZE] = {0};

void prod_proc() {
    printf("prod task start\n");

    //记录当前CPU上下文至uc[1],并切换协程至uc[2]
    //注意:此时uc[1]原本记录的CPU上下文被更新,但uc[1]协程返回的协程和任务函数没有被更新
    swapcontext(&uc[1], &uc[2]);
    printf("prod task done\n");
}

void cons_proc() {
    printf("cons task start\n");

    //同上
    swapcontext(&uc[2], &uc[1]);
    printf("cons task done\n");
}

int main(int argc, char *argv[]) {
    getcontext(&uc[1]); //记录当前CPU上下文至uc[1]
    getcontext(&uc[2]); //记录当前CPU上下文至uc[2]

    uc[1].uc_link = &uc[2]; //更新uc[1]返回跳转协程
    uc[1].uc_stack.ss_sp = stack1; //设置uc[1]协程栈
    uc[1].uc_stack.ss_size = sizeof(stack1);//设置uc[1]协程栈大小
    makecontext(&uc[1], prod_proc, 0); //调用makecontext更新协程

    uc[2].uc_link = &uc[1];
    uc[2].uc_stack.ss_sp = stack2;
    uc[2].uc_stack.ss_size = sizeof(stack2);
    makecontext(&uc[2], cons_proc, 0);

 //记录当前CPU上下文至uc[0],并切换协程至uc[1]
 //注意程序要退出,可以切换至协程uc[0],切换成功后会执行printf函数
    swapcontext(&uc[0], &uc[1]);

    printf("main done\n");
    return 0;
}
3.协程测试
1)测试代码
测试代码分别采用线程和协程完成千万次数据包入队和出队操作,统计线程和协程完成该任务的时间,对比线程和协程的性能差距。
通过修改代码中的宏参数,可以设置任务类型:线程或协程。以及设置线程数量和入队,出队数据包数量。
(完整代码可联系博主领取)
 #include <stdatomic.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>
#include <unistd.h>
#include <pthread.h>
#include <ucontext.h>

#define PROD_THREAD_NUM (1) //生产者线程数量
#define CONS_THREAD_NUM (1) //消费者线程数量
#define TOTAL_PACKET_NUM (10000000) //测试入队数据包总数量

#define TASK_TYPE (0) //任务类型:0:线程, 1:协程
#define THREAD_TYPE (0)
#define COROUTINE_TYPE (1)

#if (TASK_TYPE == THREAD_TYPE)
#define LOCK(lock) pthread_mutex_lock(lock)
#define UNLOCK(lock) pthread_mutex_unlock(lock)
#define WAIT(cond, lock) pthread_cond_wait(cond, lock);
#define SIGNAL(cond) pthread_cond_signal(&g_cond);
#else
#define LOCK(lock)
#define UNLOCK(lock)
#define WAIT(cond, lock)
#define SIGNAL(cond)
#endif

struct mini_ring;
struct mini_ring *g_ring;
_Atomic(uint32_t) g_seq; //全局数据包序列号,每产生一个新的数据包加1
_Atomic(uint32_t) g_count; //全局出队数据包序列号,每出队一个数据包加1

int g_done;

pthread_mutex_t g_mutex;
pthread_cond_t g_cond;

ucontext_t uc[3];
char stack1[8192] = {0};
char stack2[8192] = {0};

struct mini_packet {
    uint32_t seq; //数据包序列号
};

struct mini_packet *mini_packet_alloc() {
    struct mini_packet *pkt = (struct mini_packet *)malloc(sizeof(*pkt));
    if (!pkt) return NULL;

    pkt->seq = atomic_fetch_add(&g_seq, 1);
    if (pkt->seq > TOTAL_PACKET_NUM) {
        return NULL;
    }
    return pkt;
}

void mini_packet_free(struct mini_packet *pkt) {
   free(pkt);
}

struct mini_ring {
    uint32_t head;
    uint32_t tail;
    uint32_t size;
    uint32_t mask;
};

struct mini_ring* mini_ring_create(uint32_t size) {
    uint32_t count = sizeof(struct mini_ring) + (sizeof(void *) * size);
    struct mini_ring *ring = (struct mini_ring *)malloc(count);
    if (!ring) return NULL;

    ring->head = 0;
    ring->tail = 0;
    ring->size = size;
    ring->mask = size - 1;

    return ring;
}

void mini_ring_free(struct mini_ring *ring) {
    free(ring);
}

int mini_ring_enqueue_elems(struct mini_ring *ring, uint32_t *cur_head, void *obj_table, uint32_t n) {
    uint32_t id = (*cur_head) & ring->mask;
    uint64_t **slot = (uint64_t**)&ring[1];
    uint64_t **p = (uint64_t **)obj_table;
    if ((id + n) <= ring->size) {
        for (int i = 0; i < n; i++) {
            slot[id++] = p[i];
        }
    } else {
        int i = 0;
        for (; id < ring->size; i++) {
            slot[id++] = p[i];
        }
        for (id = 0; i < n; i++) {
            slot[id++] = p[i];
        }
    }
    return 0;
}

int mini_ring_enqueue(struct mini_ring *ring, void *obj_table, uint32_t n) {
    uint32_t cur_head;
    uint32_t next_head;
    uint32_t free_entries;

    LOCK(&g_mutex);
    free_entries = ring->size - (ring->head - ring->tail);
    if (n > free_entries) {
        SIGNAL(&g_cond);
        UNLOCK(&g_mutex);
        return -1;
    }

    cur_head = ring->head;
    next_head = ring->head + n;
    mini_ring_enqueue_elems(ring, &cur_head, obj_table, n);
    ring->head = next_head;
    SIGNAL(&g_cond);
    UNLOCK(&g_mutex);
    return 0;
}

int mini_ring_dequeue_elems(struct mini_ring *ring, uint32_t *cur_head, void *obj_table, uint32_t n) {
    uint32_t id = (*cur_head) & ring->mask;
    uint64_t **slot = (uint64_t**)&ring[1];
    uint64_t **p = (uint64_t **)obj_table;
    if ((id + n) <= ring->size) {
        for (int i = 0; i < n; i++) {
            p[i] = slot[id++];
        }
    } else {
        int i = 0;
        for (; id < ring->size; i++) {
            p[i] = slot[id++];
        }
        for (id = 0; i < n; i++) {
            p[i] = slot[id++];
        }
    }
    return 0;
}

int mini_ring_dequeue(struct mini_ring *ring, void *obj_table, uint32_t n) {
    uint32_t cur_tail;
    uint32_t next_tail;
    uint32_t entries;
    LOCK(&g_mutex);
    entries = ring->head - ring->tail;
#if (TASK_TYPE == THREAD_TYPE)
    while((n > entries) && (g_done == 0)) {
        WAIT(&g_cond, &g_mutex);
        entries = ring->head - ring->tail;
    }

    if (g_done != 0) {
        UNLOCK(&g_mutex);
        return -1;
    }
#else
    if (n > entries) {
        return -1;
    }
#endif

    cur_tail = ring->tail;
    next_tail = ring->tail + n;
    mini_ring_dequeue_elems(ring, &cur_tail, obj_table, n);
    ring->tail = next_tail;
    UNLOCK(&g_mutex);

    return 0;
}

#if (TASK_TYPE == THREAD_TYPE)
void *prod_task(void *arg) {
    int task_num = (int)arg;
#else
void prod_task() {
    int task_num = 0;
#endif
    uint64_t **obj_table = NULL;
    while(1) {
        struct mini_packet *pkt = mini_packet_alloc();
        if (!pkt) {
            printf("入队:%d个数据包,生产者任务:%d 退出!\n", TOTAL_PACKET_NUM, task_num);
            break;
        }
        //printf("prod task num:%d, new pkt seq:%u\n", task_num, pkt->seq);
        obj_table = (uint64_t **)&pkt;
try_again:
        int ret = mini_ring_enqueue(g_ring, (void *)obj_table, 1);
        if (ret) {
            //printf("mini ring enqueue ret:%d error\n", ret);
            goto try_again;
        }
#if (TASK_TYPE == COROUTINE_TYPE)
        //printf("uc[1] swap to uc[2]\n");
        swapcontext(&uc[1], &uc[2]);
#endif
    }

#if (TASK_TYPE == THREAD_TYPE)
    return NULL;
#endif
}

#if (TASK_TYPE == THREAD_TYPE)
void *cons_task(void *arg) {
    int task_num = (int)arg;
#else
void cons_task() {
    int task_num = 0;
#endif
    int ret = 0;
    uint64_t **obj_table = NULL;
    struct mini_packet *pkt = NULL;
    int failed_times = 0;
    uint32_t count = 0;
    while(1) {
        count = atomic_load(&g_count);
        if (count > TOTAL_PACKET_NUM) {
            printf("出队:%d个数据包,消费者任务:%d 退出!\n", count - 1, task_num);
            break;
        }
        obj_table = (uint64_t **)&pkt;
        ret = mini_ring_dequeue(g_ring, (void *)obj_table, 1);
        if (ret < 0) {
            continue;
        }

        //printf("cons task num:%d, dequeue pkt seq:%u\n", task_num, pkt->seq);

        mini_packet_free(pkt);
        atomic_fetch_add(&g_count, 1);

#if (TASK_TYPE == COROUTINE_TYPE)
        //printf("uc[2] swap to uc[1]\n");
        swapcontext(&uc[2], &uc[1]);
#endif
    }

    g_done++;

#if (TASK_TYPE == THREAD_TYPE)
    return NULL;
#endif
}

int main(int argc, char *argv[]) {
    atomic_init(&g_seq, 0);
    atomic_init(&g_count, 0);
    g_done = 0;

    int size = 4096;
    g_ring = mini_ring_create(size);

#if (TASK_TYPE == THREAD_TYPE)
    pthread_mutex_init(&g_mutex, NULL);
    pthread_cond_init(&g_cond, NULL);
    pthread_t prod_th[PROD_THREAD_NUM];
    pthread_t cons_th[CONS_THREAD_NUM];
    for (int i = 0; i < CONS_THREAD_NUM; i++) {
        pthread_create(&cons_th[i], NULL, cons_task, (void *)i);
    }
    for (int i = 0; i < PROD_THREAD_NUM; i++) {
        pthread_create(&prod_th[i], NULL, prod_task, (void *)i);
    }

    for (int i = 0; i < PROD_THREAD_NUM; i++) {
        pthread_join(prod_th[i], NULL);
    }

    while(g_done < CONS_THREAD_NUM) {
        pthread_cond_signal(&g_cond);
        usleep(10);
    }

    for (int i = 0; i < CONS_THREAD_NUM; i++) {
        pthread_join(cons_th[i], NULL);
    }

    pthread_mutex_destroy(&g_mutex);
    pthread_cond_destroy(&g_cond);

#else
    getcontext(&uc[1]);
    uc[1].uc_link = &uc[0];
    uc[1].uc_stack.ss_sp = stack1;
    uc[1].uc_stack.ss_size = sizeof(stack1);
    makecontext(&uc[1], prod_task, 0);

    getcontext(&uc[2]);
    uc[2].uc_link = &uc[0];
    uc[2].uc_stack.ss_sp = stack2;
    uc[2].uc_stack.ss_size = sizeof(stack2);
    makecontext(&uc[2], cons_task, 0);

    swapcontext(&uc[0], &uc[1]);
#endif

    printf("test done!\n");

    return 0;
}
2)测试方法
测试硬件环境:树莓派4B,内存4GB。
测试要求:1千万次入队和出队操作。
为了减少测试误差,需要将线程通过taskset命令绑定到一个CPU上,这样协程和线程都是在同一CPU上执行。
程序执行命令:time taskset -c 1 ./demo
查看线程绑定CPU情况命令:ps -eLF | grep “demo”
3)测试结果
- 情况1:1个生产者协程和1个消费者协程


结果分析:测试程序只有1个线程,线程运行在CPU1,实际时间19.6秒,用户时间8.9秒,系统时间10秒。
注意:系统时间10秒钟是由于ucontext方案swapcontext函数会执行HVC指令执行系统调用导致,这也是为什么腾讯libco协程库不使用ucontext方案的一个原因。
- 情况2:1个生产者线程和1个消费者线程


结果分析:测试程序有3个线程,线程运行在CPU1,实际时间23.0秒,用户时间14.7秒,系统时间8秒。1个生产者和消费者线程方案性能比协程方案要差一点。
- 情况3:2个生产者协程和2个消费者协程


结果分析:测试程序有5个线程,线程运行在CPU1,实际时间16.3秒,用户时间12.5秒,系统时间3.8秒。2个生产者和消费者线程方案性能比协程方案要好。感兴趣的小伙伴可以自行分析为什么多个线程的情况下,性能会优于协程方案。