 物联网心球
大家好,这里是物联网心球。
今天我们讨论的主题是无锁队列,有过代码性能优化经验的小伙伴们,应该都听过无锁队列,无锁队列在很多高性能开源项目都有运用,比如:XDP,DPDK等。
1.无锁队列简介
无锁队列是一种数据结构,它在并发编程中不依赖于传统的锁定机制(如互斥锁或信号量)来同步访问,而是利用原子操作、内存屏障或者其他非阻塞的同步原语。无锁算法通常用于提高并发性能和降低死锁风险。
优点:
高并发性:无锁队列避免了锁竞争,使得多个线程能够并行地添加和移除元素,提高了系统的吞吐量。
减少阻塞:由于没有显式锁,读写操作不会被其他线程阻塞,提高了响应时间和系统利用率。
减少上下文切换:无锁操作通常导致更少的线程上下文切换,减少了CPU开销。
缺点:
复杂性增加:实现无锁队列往往比使用锁更为复杂,需要对底层硬件和操作系统有更好的理解。
代码可读性和调试困难:由于缺乏锁的直观性,代码可能变得难以理解和维护,出错排查难度大。
适应特定环境:并非所有情况都适合无锁设计,比如处理器不支持原子操作或者内存模型不保证顺序一致性时,效果可能会大打折扣。
2.无锁队列实现原理
无锁队列的实现相对来说比较复杂,要想实现无锁队列,我们得了解一些背景知识:原子操作,内存屏障,内存顺序。
2.1 原子操作
原子操作是无锁化编程的基础,原子操作前面已经介绍过,请参考文章:
2.2 内存屏障
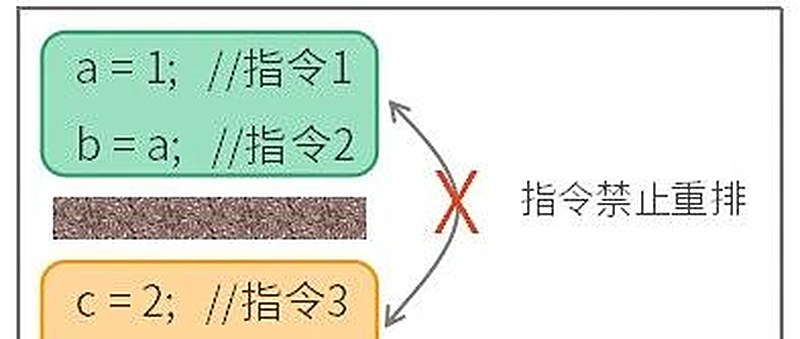
内存屏障其实就是防止指令重排的一种技术,编译器和CPU会背着程序员偷偷修改指令执行的顺序。程序没有按照程序设计的逻辑执行,导致程序出错。
如下图,程序设计的逻辑是顺序执行指令1,指令2,指令3,指令4。

编译器或CPU重排了指令1和指令3,先执行指令3再执行指令1,程序运行结果出错。

为了防止指令被重排,我们在指令2和指令3之间增加一个内存屏障,内存屏障之前的代码和内存屏障之后的代码将禁止重排,禁止重排后可以保证指令1和指令2先于指令3和指令4执行。
当然指令1和指令2之间以及指令3和指令4之间可能存在指令重排,我们可以继续增加内存屏障解决。

内存屏障是一个很复杂的概念,本文只是简单的介绍了内存屏障的工作原理,方便理解后续的概念。
2.3 内存顺序
内存顺序的定义如下:
typedef enum memory_order {
  memory_order_relaxed = __ATOMIC_RELAXED,
  memory_order_consume = __ATOMIC_CONSUME,
  memory_order_acquire = __ATOMIC_ACQUIRE,
  memory_order_release = __ATOMIC_RELEASE,
  memory_order_acq_rel = __ATOMIC_ACQ_REL,
  memory_order_seq_cst = __ATOMIC_SEQ_CST
} memory_order;
内存顺序通常是和原子操作共同使用,这样原子操作会增加额外的功能(如:内存屏障功能),无锁队列将会用到三种内存顺序:
1)memory_order_relaxed
- 只保证原子操作,不保证指令顺序。
2)memory_order_acquire
用于获取(load)原子变量值相关的操作,比如:atomic_load_explicit操作。
对于使用memory_order_acquire内存顺序的指令,该指令后面的所有读写操作不能重排在该指令之前。
当前线程执行的memory_order_acquire指令能够保证读到其他线程 memory_order_release指令之前的所有内存写入操作。
3)memory_order_release
用于设置(store)原子变量值相关的操作,比如:atomic_store_explicit操作。
对于使用memory_order_release内存顺序的指令,该指令之前的所有读写操作不能重排在该指令之后。
当前线程memory_order_release指令之前的所有内存写操作对于其他线程 memory_order_acquire指令之后可见。
注意:能否正确理解这三种内存顺序是学好无锁队列的关键!!!
三种内存顺序除了红色字体部分难理解,其他的部分相对来说比较简单,所以我们重点讲解红色字体部分。
memory_order_acquire和memory_order_release内存顺序通常来说是成对使用,实现多线程互斥访问的功能。

3.环形无锁队列
3.1 环形无锁队列整体介绍
一个完整的环形无锁队列需要具备很多要素,其中最重要的几个要素如下:
固定大小的数组,用于存放队列元素。
数组长度,用于计算已插入元素(entries)和空闲元素(free_entries)。
生产者索引,生产者索引分为头部(prod_head)和尾部(prod_tail),且都是原子整型变量。
消费者索引,消费者索引分为头部(cons_head)和尾部(cons_tail),且都是原子整型变量。

为了便于讨论无锁队列,我们把环形无锁队列看成是一个数组。通过数组我们很容易理解无锁队列入队和出队操作。

3.2 环形无锁队列入队
多个线程同时入队时,为了保证入队的正确性,需要将入队操作分为三个步骤:移动生产者头部,插入队列元素,移动生产者尾部。我们需要重点关注每一个步骤如何保证多线程安全。1)移动生产者头部

无锁队列将生产者索引分为头部和尾部,目的是为了保证多线程入队安全。如上图,3个线程同时入队,入队先后顺序为:线程1>线程2>线程3。
线程1:记录当前生产者头部位置(old_head),根据入队元素个数计算出新的生产者头部(new_head),使用CAS原子操作将prod_head设置成new_head的值。
线程2:记录当前生产者头部位置(old_head),此时的old_head为线程1更新后的prod_head值,根据入队元素个数计算出新的生产者头部(new_head),将prod_head设置成new_head的值。
线程3:同线程2。示例代码:
int mini_ring_move_prod_head(struct mini_ring *ring, uint32_t n, unsigned int *cur_head, unsigned int *next_head) {
    uint32_t cons_tail;
    int free_entries;
    bool suc;
    *cur_head = atomic_load_explicit(&ring->prod.head, memory_order_relaxed);
    do {
        cons_tail = atomic_load_explicit(&ring->cons.tail, memory_order_acquire);
        free_entries = ring->size - (*cur_head - cons_tail);
        if (n > free_entries) {
            return -1;
        }
        *next_head = *cur_head + n;
        suc = atomic_compare_exchange_strong_explicit(&ring->prod.head,
                cur_head,
                *next_head,
                memory_order_relaxed,
                memory_order_relaxed);
    } while (suc == false);
    return 0;
}
2)插入队列元素

old_head和new_head为队列元素插入的起始位置和结束位置。移动头部完成后,线程1,线程2,线程3可以同时插入队列元素。为什么3个线程同时插入队列元素不会相互干扰,大家可以思考一下。 原因在于3个线程的old_head和new_head没有重叠,所以没有藕合关系,就能同时插入队列元素。
3)移动生产者尾部

移动尾部不是简单把prod_tail设置成new_head的值,如果3个线程同时设置prod_tail的值,那么最终prod_tail的值将变得不确定,如果prod_tail的值不确定会导致无法正确记录entries(已插入元素)的起始位置。移动尾部需要具备一定的条件才能移动,条件就是线程prod_tail和old_head值相等才能移动,该条件可以限制未满足条件的线程修改prod_tail的值,并且一个线程移动完尾部,又会有其他线程满足该条件,继续移动尾部,确保多项成安全,此时3个线程只有线程1满足情况。
- 线程1:设置prod_tail为new_head,移动尾部完成。
- 线程2:线程1更新完prod_tail后,线程2检测到prod_tail等于old_head值,设置prod_tail为new_head,移动尾部完成。
- 线程3:同线程2。
示例代码:
int mini_ring_update_prod_tail(struct mini_ring *ring, uint32_t *cur_head, uint32_t *next_head) {
    while(atomic_load_explicit(&ring->prod.tail, memory_order_relaxed) != *cur_head) {}

    atomic_store_explicit(&ring->prod.tail, *next_head, memory_order_release);
}
3.3 环形无锁队列出队
环形无锁队列出队和入队非常相似,同样分为三个步骤:移动消费者头部,移出队列元素,移动消费者尾部。这里我只贴出过程图,小伙伴们自行分析实现原理。
1)移动消费者头部
 2)移出队列元素
 3)移动消费者尾部

4.无锁队列性能测试
4.1 测试方法
测试代码包括2种队列:无锁队列和互斥锁队列。 将测试代码编译成可执行程序,通过time ./程序名 执行程序,对比互斥锁队列和无锁队列执行时间,不清楚time命令的使用方法,请参考文章:Linux高性能编程_原子操作 测试代码如下:注:由于篇幅有限,测试代码仅为部分代码,需要完整版代码请联系博主。
 #include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>
#include <unistd.h>
#include <pthread.h>

#define PROD_THREAD_NUM (1) //生产者线程数量
#define CONS_THREAD_NUM (1) //消费者线程数量
#define TOTAL_PACKET_NUM (20000000) //测试入队数据包总数量

#define LOCK_TYPE (1)
#define FREE_LOCK (0)
#define MUTEX_LOCK (1)

struct mini_ring;
struct mini_ring *g_ring;
_Atomic(uint32_t) g_seq; //全局数据包序列号,每产生一个新的数据包加1
_Atomic(uint32_t) g_count; //全局出队数据包序列号,每出队一个数据包加1

int g_done;

pthread_mutex_t g_mutex;
pthread_cond_t g_cond;

struct mini_packet {
    uint32_t seq; //数据包序列号
};

struct mini_headtail {
    _Atomic(uint32_t) head;
    _Atomic(uint32_t) tail;
};

struct mini_ring {
    struct mini_headtail prod;
    struct mini_headtail cons;
    uint32_t head;
    uint32_t tail;
    uint32_t size;
    uint32_t mask;
};

int mini_ring_enqueue(struct mini_ring *ring, void *obj_table, uint32_t n) {
#if (LOCK_TYPE == FREE_LOCK)
    uint32_t cur_head;
    uint32_t next_head;

    int ret = mini_ring_move_prod_head(ring, n, &cur_head, &next_head);
    if (ret) {
        //printf("mini ring move prod head error\n");
        return -1;
    }
    mini_ring_enqueue_elems(ring, &cur_head, obj_table, n);
    mini_ring_update_prod_tail(ring, &cur_head, &next_head);
#elif (LOCK_TYPE == MUTEX_LOCK)
    uint32_t cur_head;
    uint32_t next_head;
    uint32_t free_entries;

    pthread_mutex_lock(&g_mutex);
    free_entries = ring->size - (ring->head - ring->tail);
    if (n > free_entries) {
        pthread_cond_signal(&g_cond);
        pthread_mutex_unlock(&g_mutex);
        return -1;
    }

    cur_head = ring->head;
    next_head = ring->head + n;
    mini_ring_enqueue_elems(ring, &cur_head, obj_table, n);
    ring->head = next_head;
    pthread_cond_signal(&g_cond);
    pthread_mutex_unlock(&g_mutex);
#else

#endif
    return 0;
}

int mini_ring_dequeue(struct mini_ring *ring, void *obj_table, uint32_t n) {
#if (LOCK_TYPE == FREE_LOCK)
    uint32_t cur_head;
    uint32_t next_head;

    int ret = mini_ring_move_cons_head(ring, n, &cur_head, &next_head);
    if (ret) {
        //printf("mini ring move cons head ret:%d error\n", ret);
        return -1;
    }

    mini_ring_dequeue_elems(ring, &cur_head, obj_table, n);
    mini_ring_update_cons_tail(ring, &cur_head, &next_head);
#elif (LOCK_TYPE == MUTEX_LOCK)
    uint32_t cur_tail;
    uint32_t next_tail;
    uint32_t entries;
    pthread_mutex_lock(&g_mutex);
    entries = ring->head - ring->tail;
#if 0
    if (n > entries) {
        pthread_mutex_unlock(&g_mutex);
        return -1;
    }
#else
    while((n > entries) && (g_done == 0)) {
        pthread_cond_wait(&g_cond, &g_mutex);
        entries = ring->head - ring->tail;
    }

    if (g_done != 0) {
        pthread_mutex_unlock(&g_mutex);
        return -1;
    }
#endif

    cur_tail = ring->tail;
    next_tail = ring->tail + n;
    mini_ring_dequeue_elems(ring, &cur_tail, obj_table, n);
    ring->tail = next_tail;
    pthread_mutex_unlock(&g_mutex);
#else
#endif
    return 0;
}

void *prod_thread(void *arg) {
    int thread_num = (int)arg;
    uint64_t **obj_table = NULL;
    while(1) {
        //for (int i = 0; i < 10000; i++) ;
        struct mini_packet *pkt = mini_packet_alloc();
        if (!pkt) {
            printf("入队:%d个数据包,生产者线程:%d 退出!\n", TOTAL_PACKET_NUM, thread_num);
            break;
        }
        //printf("prod thread num:%d, new pkt seq:%u\n", thread_num, pkt->seq);
        obj_table = (uint64_t **)&pkt;
try_again:
        int ret = mini_ring_enqueue(g_ring, (void *)obj_table, 1);
        if (ret) {
            //printf("mini ring enqueue ret:%d error\n", ret);
            goto try_again;
        }
    }

    return NULL;
}

void *cons_thread(void *arg) {
    int thread_num = (int)arg;
    int ret = 0;
    uint64_t **obj_table = NULL;
    struct mini_packet *pkt = NULL;
    int failed_times = 0;
    uint32_t count = 0;
    while(1) {
        count = atomic_load(&g_count);
        if (count > TOTAL_PACKET_NUM) {
            printf("出队:%d个数据包,消费者线程:%d 退出!\n", count - 1, thread_num);
            break;
        }
        obj_table = (uint64_t **)&pkt;
        ret = mini_ring_dequeue(g_ring, (void *)obj_table, 1);
        if (ret < 0) {
            if (failed_times < 1000) {
                failed_times++;
            } else {
                //printf("dequeue failed times:%d\n", failed_times);
                usleep(10);
                failed_times = 0;
            }
            continue;
        }

#if 0
        if ((pkt->seq % 1000) == 0){
            printf("cons thread num:%d, dequeue pkt seq:%u\n", thread_num, pkt->seq);
        }
#endif
        mini_packet_free(pkt);
        atomic_fetch_add(&g_count, 1);
    }

    g_done++;

    return NULL;
}

int main(int argc, char *argv[]) {
    atomic_init(&g_seq, 0);
    atomic_init(&g_count, 0);
    pthread_mutex_init(&g_mutex, NULL);
    pthread_cond_init(&g_cond, NULL);
    g_done = 0;

    int size = 4096;
    g_ring = mini_ring_create(size);

    pthread_t prod_th[PROD_THREAD_NUM];
    pthread_t cons_th[CONS_THREAD_NUM];
    for (int i = 0; i < CONS_THREAD_NUM; i++) {
        pthread_create(&cons_th[i], NULL, cons_thread, (void *)i);
    }
    for (int i = 0; i < PROD_THREAD_NUM; i++) {
        pthread_create(&prod_th[i], NULL, prod_thread, (void *)i);
    }

    for (int i = 0; i < PROD_THREAD_NUM; i++) {
        pthread_join(prod_th[i], NULL);
    }

    while(g_done < CONS_THREAD_NUM) {
        pthread_cond_signal(&g_cond);
        usleep(10);
        //printf("g_done:%d\n", g_done);
    }

    //printf("--g_done:%d\n", g_done);
    for (int i = 0; i < CONS_THREAD_NUM; i++) {
        pthread_join(cons_th[i], NULL);
    }

    pthread_mutex_destroy(&g_mutex);
    pthread_cond_destroy(&g_cond);

    return 0;
}
4.2 测试结果
测试硬件环境:树莓派4B,内存4GB。测试要求:2千万次入队和出队操作。1)1个生产者和1个消费者 无锁队列»>

结果分析:实际运行时间为8.3秒,系统运行时间为0.0秒,无系统调用。 互斥锁队列 »>

结果分析:互斥锁队列运行很不稳定,实际运行时间超过10分钟。
2)1个生产者和2个消费者 无锁队列»>

结果分析:实际运行时间为8.3秒,系统运行时间为0.1秒,无系统调用。 互斥锁队列»>

结果分析:实际运行时间为15.6秒,系统运行时间为19.9秒,存在大量系统调用。 3)2个生产者和1个消费者无锁队列»>

结果分析:实际运行时间为7.9秒,系统运行时间为0.0秒,无系统调用。 互斥锁队列»>

结果分析:实际运行时间为26.5秒,系统运行时间为29.7秒,存在大量系统调用。 4)2个生产者和2个消费者无锁队列»>

结果分析:实际运行时间为6.18秒,系统运行时间为0.0秒,无系统调用。 互斥锁队列»>

结果分析:实际运行时间为11.8秒,系统运行时间为22.1秒,存在大量系统调用。