 物联网心球
大家好,这里是物联网心球。
今天我们要讨论的高性能编程主题是Reactor模型,通过Reactor我们要实现百万并发请求。
1.聊聊百万并发
1.1 什么是百万并发?
百万并发是指一个系统能够同时处理一百万以上的并发连接或请求。
通常指的是网络服务器或应用程序能够支持大量用户的同时访问而不会出现性能瓶颈或崩溃的情况。
实现百万并发不仅要求硬件资源(如CPU、内存、网络带宽等)足够强大,还需要软件架构能够高效地进行负载均衡、会话管理、数据处理等操作。
为了达到百万并发级别的处理能力,通常需要以下几个方面的考量和实施:
分布式架构设计
负载均衡
缓存策略
异步处理
1.2 百万并发性能瓶颈
本文讨论的百万并发指的是单机百万并发,要实现百万并发,我们需要对硬件和软件都要进行优化。
硬件瓶颈: CPU,内存,带宽等,硬件瓶颈可以通过升级硬件解决。
系统瓶颈:端口号限制,文件描述符限制,内存限制,线程数量限制,系统瓶颈可以通过优化系统解决。
1)端口号限制
不管是TCP连接还是UDP连接都会涉及到一个概念:四元组。
四元组包括:源IP,源端口,目的IP,目的端口。

四元组信息是一个连接的身份信息,四元组中任何一组数据发生改变,意味着这是一条新的连接。
理论上一台主机最多可以创建2^32 * 2^16 * 2^32 * 2^16个连接。但实际情况受到IP和端口的限制,不可能达到理论上最大连接数。
我们以单主机单IP来讨论实际最大连接数。
- 服务端
服务端绑定IP(192.168.19.10)和端口(9999)。
那么服务端只有目的IP和目的端口能够变化,最大连接数为:
2^32 * 2^16 = 281470681677825,远远大于100万连接。
实际情况:目的IP不可能达到2^32,目的端口范围1024-65535,但即使不能达到最大值,服务端支持的连接数远远大于100万。
- 客户端
客户端绑定IP(192.168.19.20),连接服务器IP(192.168.19.10)和端口(9999)。
由于源IP,目的IP,目的端口都已经固定,只有源端口能够变化,最大连接数:2^16 = 65535,小于100万连接。
实际情况:源端口范围1024-65535。
单主机要测试百万连接,需要启动将近20个(100万除以6万)不同源IP的客户端。
2)文件描述符限制
Linux一切皆文件,每个TCP或者UDP连接都对应一个文件,如果想支持高并发场景,需要优化最大文件描述符的限制。
默认情况下,一个进程最多打开1024个文件描述符,通过ulimit -n命令查看。

优化方法如下:
步骤1:修改系统最大文件描述符限制
 # vim /etc/sysctl.conf
fs.file-max=1200000
fs.nr_open=1200000
# sysctl -p
步骤2:修改进程最大文件描述符限制
 # vim /etc/security/limits.conf
* soft nofile 1001024
* hard nofile 1001024
root soft nofile 1001024
root hard nofile 1001024
*和root代表用户名,修改完成后,创建新的窗口,执行ulimit -n命令,可以看到单进程最大文件描述符变为1001024。

3)内存限制
每个网络连接都需要在用户空间和内核空间创建一些对象(struct file,struct socket),这些对象都会有内存开销.
假如每个网络连接需要5KB的内存空间,百万连接占用的内存空间为:
100 * 10000 * 5KB = 4.7GB。
需要至少8BG内存才能支持百万连接。
4)线程数量限制
100万个连接对应的是100万个业务,客户端和服务端需要通过网络连接频繁地进行网络通信。
传统的做法是每个连接创建一个线程,通过线程来进行数据收发,100万个连接意味着要创建100万个线程。

单主机能支持100万个线程吗?
答案:不能,原因有两点。
- 原因1:一个线程默认需要8MB栈空间,100万个连接需要:
100 * 10000 * 8MB = 7.6TB内存空间,内存开销是天文数字。
- 原因2: CPU需要调度100万个线程,很多线程分不到时间片会饿死,所以一个连接对应一个线程无法处理百万个连接。
为了解决线程数量限制,我们需要使用Reactor模型。
2.Reactor模型简介
2.1 Reactor模型是什么?
Reactor(反应堆)模型是一种基于事件驱动的设计模式,用于构建可扩展的高性能和高并发的应用程序。这种模式在处理大量并发请求时特别有效,它允许一个或多个输入源(例如,客户端连接)被非阻塞地处理。
在Reactor模式中,通常有一个或多个事件循环(Event Loop),它们负责调用注册的事件处理器,以响应发生的事件。
很多开源网络架构都应用了Reactor技术,如:Netty,Nginx,libevent,muduo等等。
2.2 Reactor模型分类
Reactor可以分为:单线程Reactor模型,多线程Reactor模型,主从Reactor模型,多进程模型。
多进程模型是比较特殊的模型,目前只有Nginx采用多进程模型。
(本文暂时不讨论多进程模型)
1)单线程Reactor模型

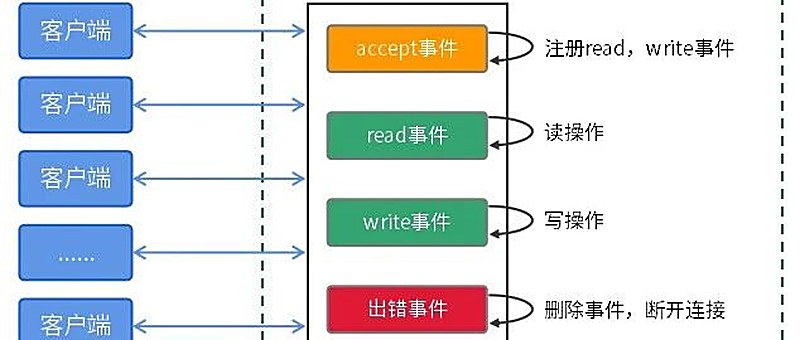
单线程Reactor模型,只有一个线程完成所有的事件操作,对于Linux系统来说,通过一个epoll线程完成事件的监听,事件注册,读写操作,事件删除等操作。
如果CPU性能足够好,单线程Reactor是能够处理百万个连接的。
单线程模型的缺点:只能使用处理器的一个CPU核,性能瓶颈在单个CPU核。目前多核处理器已经是主流,特别是服务器的CPU核心比较多,所以为了进一步提高并发能力,通常情况下不会使用单线程模型。
2)多线程Reactor模型

多线程Reactor模型在单线程模型的基础上做了改进,增加了线程池,通过线程池处理网络连接的读写操作。
epoll线程负责事件监听和事件删除,将socket读写事件操作打包成任务并插入任务队列,线程池不断从任务队列获取任务并异步执行任务。
由于增加了线程池,可以通过设置线程池大小,合理的使用CPU核心。
多线程模型的缺点:单个epoll线程很容易成为性能瓶颈。
3)主从Reactor模型

主从Reactor模型在多线程模型的基础上增加了更多的epoll线程。
如上图是一主一从模式,当然也可以一主多从模式,主epoll线程主要用来做事件监听,并添加读写事件至从epoll线程。
从epoll线程监听到读写事件后,将读写事件插入任务队列,由线程池处理读写事件。
主从Reactor模型相对来说比较成熟,没有明显的性能瓶颈点。
3.实现Reactor模型
本文实现了三种Reactor模型,通过宏开关可以配置成指定的Reactor模型。
Reactor模型可以拆分成以下组件:Reactor,事件管理器,线程池,任务队列。
3.1 Reactor编程
1)Reactor
Reactor定义如下:
enum reactor_type {
    MAIN_REACTOR, //主reactor
    SUB_REACTOR, //从reactor
};

//reactor结构体
struct reactor {
    char *name; //reactor名称
    int efd; //epoll fd
    enum reactor_type type; //reactor类型
};
Reactor是一个struct reactor对象,对象成员efd用来绑定epoll,type用来区分Reactor类型。
2)事件管理器
事件定义如下:
//事件处理函数类型
typedef void (*func)(void *arg);
//事件定义
struct event {
    struct list_head list;
    int fd; //事件绑定的socket
    func handler; //回调函数
    void *arg; //回调函数参数
};

//新建时间
struct event* event_new(void) {
    return (struct event *)malloc(sizeof(struct event));
}
//事件初始化
void event_init(struct event *ev, func handler, void *arg) {
    list_entry_init(&ev->list);
    ev->handler = handler;
    ev->arg = arg;
}
//删除事件
void event_free(struct event *ev) {
    if (ev->arg) free(ev->arg);
    free(ev);
}
事件和socket进行绑定,epoll监听到新的socket连接时,创建struct event对象,对象的fd成员和socket进行绑定。
当epoll检测到EPOLLIN或EPOLLOUT时,需要通过socket确定struct event对象,所以在epoll注册事件时,需要将struct event对象地址传入epoll事件,如:
struct epoll_event ee;
ee.events = EPOLLIN|EPOLLET;
ee.data.ptr = (void *)ev; //将事件传入epoll
3)线程池
线程池就是一个普通的线程池,如下:
//定义线程池
struct thread_pool {
    struct list_head head;  //任务队列
    uint32_t threads; //线程池工作线程数量
    pthread_t *th;
    pthread_mutex_t mutex;
    pthread_cond_t cond;
    bool done; //线程池退出标志
};

//线程池处理函数
void *thread_proc(void *arg) {
    struct thread_pool *pool = (struct thread_pool *)arg;
    while(!pool->done) {
        struct event *ev = thread_pool_get(pool);
        if (!ev) continue;
        ev->handler(ev->arg);
    }
    return NULL;
}

//线程池初始化
void thread_pool_init(struct thread_pool *pool, uint32_t threads) {
    pool->done = false;
    list_head_init(&pool->head);
    pthread_mutex_init(&pool->mutex, NULL);
    pthread_cond_init(&pool->cond, NULL);
    pool->threads = threads;
    pool->th = (pthread_t *)malloc(threads * sizeof(pthread_t));
    for (int i = 0; i < pool->threads; i++) {
        pthread_create(&pool->th[i], NULL, thread_proc, (void *)pool);
    }
}

//销毁线程池
void thread_pool_destroy(struct thread_pool *pool) {
    pool->done = true;
    for (int i = 0; i < pool->threads; i++) {
        pthread_join(pool->th[i], NULL);
    }

    pthread_mutex_destroy(&pool->mutex);
    pthread_cond_destroy(&pool->cond);
}

//线程池添加任务
void thread_pool_add(struct thread_pool *pool, struct event* ev) {
    pthread_mutex_lock(&pool->mutex);
    list_add(&ev->list, &pool->head);
    pthread_cond_signal(&pool->cond);
    pthread_mutex_unlock(&pool->mutex);
}

//从任务队列获取任务
struct event *thread_pool_get(struct thread_pool *pool) {
    pthread_mutex_lock(&pool->mutex);
    while(is_empty(&pool->head) && !pool->done) {
        struct timeval now;
        gettimeofday(&now, NULL);
        struct timespec outtime;
        outtime.tv_sec = now.tv_sec + 1;
        outtime.tv_nsec = now.tv_usec * 1000;
        pthread_cond_timedwait(&pool->cond, &pool->mutex, &outtime);
    }
    if (pool->done) {
        pthread_mutex_unlock(&pool->mutex);
        return NULL;
    }

    struct event *ev = (struct event *)list_del(&pool->head);
    pthread_mutex_unlock(&pool->mutex);
    return ev;
}
4)任务队列
任务队列是一个双向循环列表,用于缓存struct event对象。
struct list_head {
    struct list_head *prev, *next;
};

void list_entry_init(struct list_head *entry) {
    entry->prev = NULL;
    entry->next = NULL;
}

void list_head_init(struct list_head *head) {
    head->prev = head;
    head->next = head;
}

void list_add(struct list_head *new, struct list_head *head
{
    struct list_head *next = head->next;
    head->next = new;
    new->prev = head;
    new->next = next;
    next->prev = new;
}

struct list_head* list_del(struct list_head *head) {
    if (head->prev == head) return NULL;
    struct list_head *prev = head->prev;
    prev->prev->next = head;
    head->prev = prev->prev;
    return prev;
}

bool is_empty(struct list_head *head) {
    return head->next == head;
}
3.2 完整代码
完整代码包括:服务端代码,客户端代码,测试脚本。

(需要完整代码的小伙伴,请私信博主获取 )
4.Reactor单机百万连接测试
1)测试环境
服务端:树莓派4B,4核A72,内存4GB。
客户端:RK3566,4核A55,内存4GB。
2)测试方法
服务端设置最大文件描述符限制为1001024,服务端绑定IP(192.168.19.10)和端口(9999),服务端采用主从Reactor模型,共6个线程。

启动服务端程序:./server
客户端设置最大文件描述符限制为1001024,客户端一个网卡设置20个IP地址,IP地址范围(192.168.19.20-192.168.19.39),每个IP地址对应50000个端口号,共100万个连接。

启动20个客户端程序:./client 源IP 3)测试结果
服务端共创建80万个连接。

没有达到100万个连接的原因是内存耗尽,系统停止工作。
