 物联网心球
大家好,这里是物联网心球。 上一篇文章4张图搞清楚gdb工作原理成为了一篇热门文章,我想大家对于gdb都比较感兴趣。本文我们来探讨gdb另外一个比较重要的话题:coredump文件。 coredump文件能够帮助我们解决程序异常退出等严重问题,那么它是如何做到的呢?带着这个问题,开始本文的学习。
1.coredump文件介绍
coredump文件又称核心转储文件,它是一个程序运行时的完整内存快照,通常在程序异常退出时由操作系统自动生成。它包含了程序异常退出时的内存状态、寄存器值、调用栈、线程状态等信息。开发者使用调试工具(如gdb)分析这些信息就能够找到程序崩溃的原因。
coredump文件并不神秘,它只是一个ELF文件而已。关于ELF文件介绍,我的这篇文章:从ELF文件到Linux进程已经做了详细的介绍,这里不再赘述。
coredump文件格式如图1所示。

图1 coredump文件介绍
coredump文件格式包含4个部分:ELF头、程序头表、NOTE段和LOAD段。
- ELF头的Type(文件类型)字段为CORE,表示这是一个核心转储文件,如图2所示。

图2 coredump文件ELF头
* 程序头表描述了coredump文件中各个段(NOTE段和LOAD段)的信息,包括段的类型、偏移量、虚拟地址、文件大小、内存大小、访问权限等,如图3所示。
图3 coredump文件程序头表
* NOTE段包含关于线程(这里的线程指主线程和所有子线程)相关的信息,如寄存器状态、信号信息、进程状态等。 * LOAD段包含程序的内存映像,如数据段、堆、栈、内存映射等。注意:coredump文件没有节头表和节。
2.从内核看coredump文件生成过程
coredump文件生成过程包含以下几个步骤:
步骤1:用户程序执行非法操作。
步骤2:内核检测到用户程序执行非法操作,发送异常信号(如SIGSEGV信号)至进程。
步骤3:内核处理进程异常信号。
步骤4:执行核心转储过程,将进程内存数据写入coredump文件。
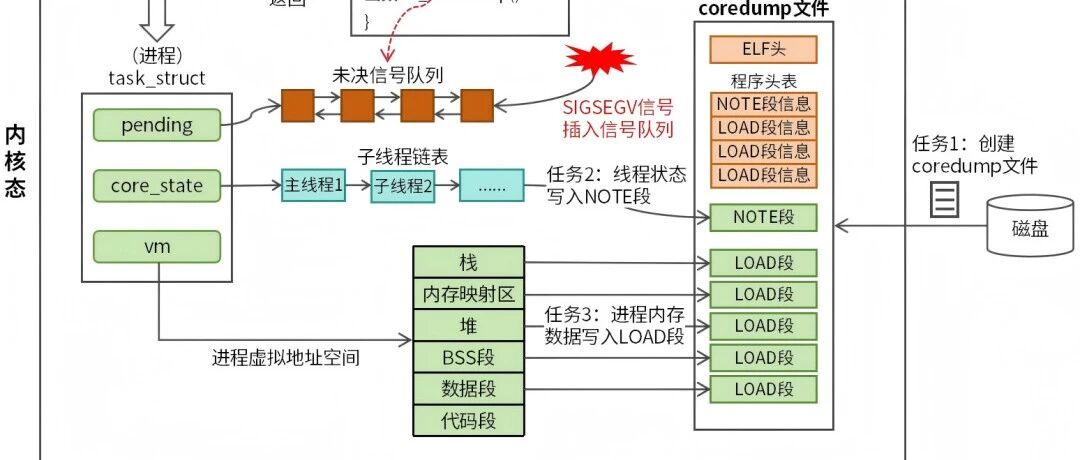
我们通过一张图来辅助理解coredump文件生成过程,如图4所示。

图4 coredump文件产生过程
当用户程序(进程)在执行的过程中出现严重错误:非法内存访问、非法指令、段错误、浮点异常等,内核会发送异常信号至进程,常见异常信号如下:
- SIGSEGV:非法内存访问(如空指针解引用、越界访问等)。
- SIGABRT:程序调用 abort()函数。
- SIGILL:非法指令(如硬件不支持的指令)。
- SIGFPE:浮点异常(如除以零)。
- SIGBUS:总线错误(如未对齐的内存访问)。
以SIGSEGV信号为例,内核产生的SIGSEGV信号会插入进程未决信号队列。当进程从内核态切换至用户态的过程中,会执行信号处理函数do_signal,该函数会轮询未决信号队列,并执行SIGSEGV信号对应的处理函数。默认情况下,SIGSEGV信号的处理函数为do_coredump函数。 do_coredump函数为核心转储函数,它将创建coredump文件并将进程内存数据写入coredump文件。coredump文件的写入需要按照严格的顺序,这样才能保证coredump文件格式正确,具体顺序如下:
步骤1:写入ELF文件头。
步骤2:写入程序头表。
步骤3 :写入辅助信息至NOTE段。收集线程信息、寄存器信息等辅助信息,将这些信息写入NOTE段。注意,进程task_struct结构有一个core_state成员,该成员维护了一个子线程链表,通过该成员可以获取所有子线程的状态和寄存器信息,将这些信息写入NOTE段,gdb就能够进行多线程调试了。
步骤4 :写入内存数据至LOAD段。遍历进程的内存映射区域(VMA),包括数据段、堆、栈等。将每个内存段的内容写入coredump文件。
细心的小伙伴会发现一个问题:代码段没有写入coredump文件?
代码段不写入coredump文件,是因为代码段是只读的且通常映射到可执行文件,其内容在程序运行时不会改变。gdb可以直接从可执行文件中读取代码段的内容,因此将其包含在coredump文件中是冗余的,会增加文件大小。
3.生成coredump文件的两个条件
在用gdb进行调试时,大家经常会碰到以下两个问题:
- 问题1:系统没有生成coredump文件?
- 问题2:系统虽然产生了coredump文件,但不知道文件在哪里?
要解决这两个问题,我们需要对生成coredump文件的两个条件有深入的理解,这两个条件为:
- 条件1:coredump文件大小限制。
- 条件2:coredump文件名。

图5 生成coredump文件的两个条件
如图5所示,内核执行do_coredump函数时,会判断CORE限制值是否小于min_coredump(内核定义的一个变量,如X86系统为4096,单位字节),如果条件成立,那么核心转储失败,系统不会创建coredump文件。简单来说,就是如果coredump文件大小限制小于4096字节,do_coredump函数将不会创建coredump文件。所以我们需要将coredump文件大小限制设置成超过4096字节的数值,让do_coredump函数成功创建coredump文件。通常我们会通过以下命令来修改:
ulimit -c unlimited
上述命令表示不限制coredump文件大小。进程资源限制请参考我的这篇文章:从ulimit命令看Linux进程资源限制。 判断完coredump文件大小限制,接着就是创建coredump文件,创建coredump文件时,需要指定coredump文件名。如果我们不清楚内核创建coredump文件时,如何指定coredump文件名,那么我们自然就不会知道coredump存储系统哪个位置。 coredump文件名由系统文件:/proc/sys/kernel/core_pattern(简称core_pattern文件)决定。core_pattern文件位于用于控制 Linux 系统中coredump文件的生成行为,包括文件名格式和存储位置。通过修改该文件的内容,用户可以自定义coredump文件的命名规则和存储路径,例如包含进程ID、信号编号、时间戳等信息。core_pattern的语法规则比较复杂,大家可以自行上网了解更详细的使用方法。 我们通过cat命令查看一下core_pattern文件,如下:
# cat /proc/sys/kernel/core_pattern
/tmp/core
/tmp/core表示coredump文件存储在/tmp目录,文件名为core。开发者只要正确设置以上两个条件,就能正确生成coredump文件。
4.gdb高效调试coredump文件
有了前面对coredump文件格式以及coredump文件生成原理的介绍,大家对coredump文件有了更深入的理解。此时,我们再去使用gdb调试coredump文件时,会发现gdb的使用变得很简单了。

图6 gdb高效调试coredump文件
如图6所示,所谓gdb调试coredump文件,其实就是通过gdb命令将coredump文件中的NOTE段和LOAD段记录的数据展示出来。下面我们介绍gdb调试几种常见的场景。
- 场景1:显示线程信息
通过info threads命令可以查看所有的线程,输出示例如下:

主线程和子线程信息都记录在coredump文件的NOTE段,执行info threads命令将会从NOTE段解析出线程相关的信息。当我们想调试某个特定的线程时,可以通过命令:thread 线程Id 切换至该线程,再进行调试,输出示例如下:

- 场景2:显示寄存器信息
通过info register命令可以查看线程寄存器状态,输出示例如下(以X86为例):

寄存器状态同样存储在NOTE字段,每个线程都有独立的寄存器状态,使用thread命令切换不同的线程,就能够显示不同线程的寄存器状态。当我们要查看线程栈信息时,我们需要借助rsp(栈指针寄存器)找到进程栈或线程栈所在位置,再通过bt命令显示栈信息。
- 场景3:显示栈信息
调试段错误时,最好的办法是将进程或线程的栈信息打印出来,这样就准确定位问题的具体位置。打印栈信息命令为bt,输出示例如下:

每个线程都有自己的栈信息,栈信息存储在coredump文件LOAD段,进程栈和线程栈的介绍,请查看我的这篇文章:进程栈和线程栈傻傻分不清楚。
- 场景4:打印变量信息
当我们在调试程序时,我们经常需要知道程序中变量(局部变量、全局变量)的值,这些变量存储在coredump文件的NOTE字段。以局部变量为例,我们需要显示某个局部变量,可以通过print命令查看,输出示例如下:

我们也可以通过info locals命令,查看当前所有的局部变量,输出示例如下:
