 物联网心球
大家好,这里是物联网心球。今天我们来聊聊堆栈,堆栈是软件开发人员绕不过的一个概念。堆栈指的是堆和栈两种内存区域。很多读者喜欢从数据结构的角度来学习堆栈,这种方式并不会让大家真正理解堆栈。
1.进程地址空间
进程地址空间可以分为两种类型:用户空间和内核空间。用户空间是操作系统为每个进程分配的私有地址空间,是进程可以直接访问的内存区域,如图1所示。

图1 进程地址空间
以32位系统为例,用户空间被划分为以下几个区域:
- 代码段(Text Segment):存放程序的指令代码,是只读区域。
- 数据段(Data Segment):存储程序中已初始化的全局变量和静态变量,是可读写的区域,用于存放程序运行时的数据。
- BSS段(Block Started by Symbol Segment):存放未初始化的全局变量和静态变量,程序启动时由操作系统初始化为零。
- 堆(Heap):用于动态内存分配,程序运行时通过 malloc 或 new 等函数分配内存,大小可变,用于存储动态数据。
- 栈(Stack):用于存储函数调用时的局部变量、函数参数和返回地址等信息,大小有限,遵循后进先出(LIFO)原则。
虽然进程地址空间被划分为不同的区域,但是这些区域并没有本质的区别,它们只是一块用于存储数据或代码的内存区域而已。就像我们买了一个房子,我们会对每个房间的功能进行划分,以此来满足我们的生活需求,但是每个房间并没有本质区别。 进程地址空间指的是虚拟地址空间,虚拟地址空间的范围为0-4G(32位系统),0-3G(0XC0000000)为用户空间,3G-4G为内核空间。虚拟地址需要转换成物理地址才能访问物理内存或者外部设备,转换的方法是页表机制,有兴趣的同学可以看一下我的这篇文章:一张图搞懂mmap实现原理(通俗易懂)
2.堆和栈实现原理
关于进程地址空间,有过一定编程经验的同学应该都很了解。但是,对于大部分读者来说,进程地址空间仅仅只是一个理论模型,本节我们把进程地址空间具象化(从理论模型变为具体实现),让大家彻底搞懂它。

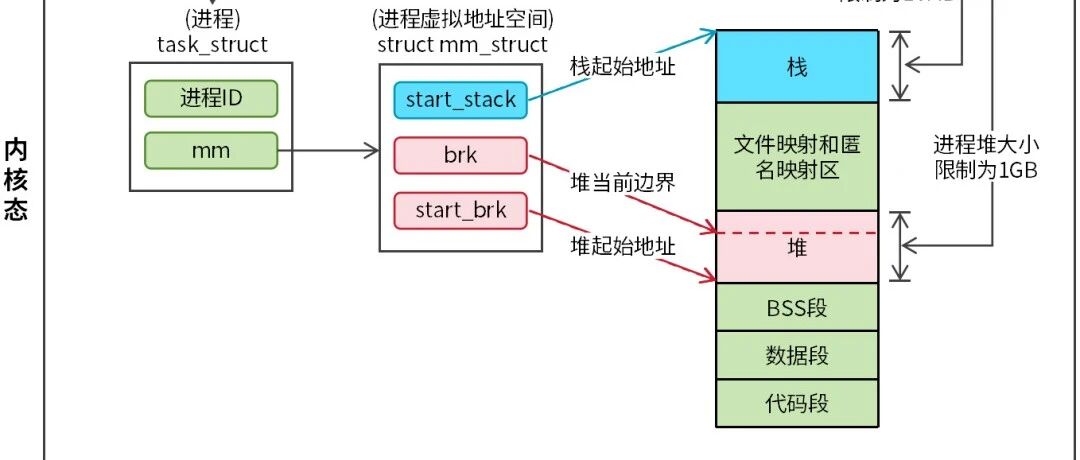
图2 进程地址空间的内核实现
如图2所示,从内核的角度来看,每个用户程序都是一个task_struct结构,task_struct结构表示一个进程或者线程,其定义如下:
struct task_struct {
    /* 1. 进程状态与标识 */
    volatile long           state; // 进程状态:TASK_RUNNING(运行/就绪), TASK_INTERRUPTIBLE(可中断睡眠) 等[1]()[2]()
    pid_t                   pid; // 进程唯一标识符 (PID)
    pid_t                   tgid; // 线程组 ID(主线程 PID,用于标识线程归属)
    char                    comm[TASK_COMM_LEN]; // 进程名称(如通过 `ps` 查看的命令名)

    /* 2. 调度信息 */
    int                     prio; // 动态优先级(调度器实际使用的优先级)
    int                     static_prio; // 静态优先级(用户设定的基准值)
    unsigned int            policy; // 调度策略:SCHED_NORMAL(普通), SCHED_FIFO(实时先进先出) 等[1]()[7]()
struct sched_info       sched_info;
// 调度统计信息(如运行时间片)

    /* 3. 进程关系 */
    struct task_struct __rcu *real_parent; // 原始父进程(创建者)
struct task_struct __rcu *parent;
// 当前父进程(接收 SIGCHLD 信号)
struct list_head        children;
// 子进程链表头
struct list_head        sibling;
// 兄弟进程链表节点(链接到父进程的 children 链表)

    /* 4. 内存与资源 */
struct mm_struct        *mm;
// 进程内存管理结构(虚拟内存布局、页表等)
struct fs_struct        *fs;
// 文件系统信息(工作目录、根目录)
struct files_struct     *files;
// 打开的文件描述符表

    /* 5. 信号处理 */
    sigset_t                pending; // 待处理信号集
    sigset_t                blocked; // 阻塞(屏蔽)信号掩码
    struct signal_struct    *signal;// 信号处理函数及共享属性(如线程组共享信号)

};
task_struct结构中有一个mm成员(struct mm_struct结构),这个成员就是用来表示进程地址空间,struct mm_struct结构体定义如下:
struct mm_struct {
    /* 1. 页表与地址空间 */
    pgd_t *pgd; // 页全局目录(Page Global Directory)基地址
    unsigned long task_size; // 用户空间大小(TASK_SIZE 常量值)
    unsigned long mmap_base; // 内存映射起始地址(栈/共享库的基准)

    /* 2. 内存布局关键边界 */
    unsigned long start_code, end_code; // 代码段起始/结束地址
    unsigned long start_data, end_data; // 数据段起始/结束地址
    unsigned long start_brk, brk; // 堆起始地址/当前堆顶
    unsigned long start_stack; // 栈起始地址(向下增长)

};
mm_struct结构的start_code和end_code成员记录了代码段的起始和结束地址,start_data和end_data成员记录了数据段的起始和结束地址。start_brk和brk成员记录了堆的起始地址和当前边界地址(堆顶),start_stack记录了栈的起始地址(栈底)。到了这一步,我想读者们对进程地址空间开始有直观的了解了。说句题外话,每个进程都会通过虚拟地址空间来记录数据和代码片段,对于内核来说,进程就是一个个代码和数据的集合。进程的调度就是CPU选择不同的代码和数据来运行的过程。本文的主角是堆和栈,我们把注意力放在堆和栈上面。我们先来聊聊栈,start_stack记录栈的起始地址(栈底),即栈空间的最高地址(栈从高地址向低地址增长)。只知道栈的起始地址还不够,我们还要知道栈的大小,这样才能完整描述一个栈空间。进程栈的大小默认为8MB,可通过ulimit -s命令查看和修改。我们再来聊聊堆,start_brk 记录堆的起始地址 (堆空间的最低地址,堆从低地址向高地址增长),brk记录堆的当前边界地址(堆顶) ,堆的实际大小通过brk-start_brk来计算。堆的最大值默认是没有限制的(受物理内存限制),可通过ulimit -d命令查看和修改。由于堆的大小没有限制,所以我们编程时,如果需要申请一大块内存,通常需要从堆空间进行申请(调用malloc等函数)。为什么堆有一个brk成员?堆的最大值通常是没有限制的或者会被限制为一个比较大的值。如果堆空间的虚拟地址全部映射为物理地址,那么物理地址可能会被耗尽。然而这仅仅只是一个进程的堆空间地址映射,如果系统中每个进程都进行堆空间地址映射,这将是一场灾难。为了避免出现这样的问题,内核通过brk成员来动态指定堆的实际大小,即按需进行堆空间地址映射。当用户程序使用的堆内存超过brk时,调高brk值进行扩容,当回收了大块堆内存时,调低brk进行缩容。
3.正确使用堆
相较于堆,栈的使用非常简单,因为栈不需要用户程序手动管理,系统会自动帮我们管理栈内存的申请和释放。需要注意的是,用户程序不能进行一些违规的操作,如:创建一个超大的局部数组或者进行无限递归调用,这样会导致栈溢出等问题。堆的使用比较复杂,用户程序除了需要动态申请和释放堆内存,还要进行动态扩容和缩容。
3.1 堆内存动态扩容和缩容
Linux系统通过系统调用或glibc提供的接口来实现堆内存动态扩容和缩容。扩容和缩容的本质是修改struct mm_struct结构的brk成员的值。
1.brk系统调用
brk系统调用定义如下:
#include <sys/syscall.h>
syscall(SYS_brk, addr);
参数说明:addr为unsigned long类型,表示堆当前边界值,分为以下几种情况:
- 扩展堆:当 addr > 当前堆顶时,向上移动brk指针,分配新内存,调用成功后返回更新后的堆当前边界值。
- 收缩堆:当 addr < 当前堆顶时,向下移动brk指针,释放堆顶内存,调用成功后返回更新后的堆当前边界值。
- 查询边界:
brk(0)返回堆当前边界值。具体实现原理如图3所示。

图3 brk系统调用实现原理
brk系统调用示例代码如下:
// 获取当前堆的结束地址
void* current_brk = (void*) syscall(SYS_brk, 0);
printf("current heap end: %p\n", current_brk);

// 尝试将堆的大小增加 1024 字节
void* new_brk = (void*) syscall(SYS_brk, (unsigned long)current_brk + 1024);
printf("new heap end: %p\n", new_brk);

// 尝试将堆的大小减少 512 字节
new_brk = (void*) syscall(SYS_brk, (unsigned long) new_brk - 512);
printf("new heap end: %p\n", new_brk);
2.glibc brk函数
需要注意的是,glibc也定义了一个brk函数(非系统调用),函数原型如下:
#include <unistd.h>
int brk(void *addr);
参数说明:addr为void *类型,分为以下几种情况:
扩展堆:当 addr > 当前堆顶时,向上移动 brk 指针,分配新内存。
收缩堆:当 addr < 当前堆顶时,向下移动brk指针,释放堆顶内存。
返回值:
成功:返回 0。
失败:返回 -1,并设置errno为ENOMEM,表示内存不足或请求不合理。
注意:glibc定义的brk函数传入参数0,并不会返回堆当前边界值。
glibc brk函数示例代码如下:
// 获取当前堆的结束地址
void* current_brk = sbrk(0);
printf("current heap end: %p\n", current_brk);

// 尝试将堆的结束地址移动 1024 字节
brk(current_brk + 1024);

// 再次获取当前堆的结束地址
void* new_brk = sbrk(0);
printf("new heap end: %p\n", new_brk);

// 尝试将堆的结束地址减少 512 字节
brk(new_brk - 512);

// 再次获取当前堆的结束地址
void* final_brk = sbrk(0);
printf("final heap end: %p\n", final_brk);
3. glibc sbrk函数
为了更方便地设置堆的大小,glibc还定义了一个sbrk函数,sbrk函数原型如下:
#include <unistd.h>
void* sbrk(int ptr_t increment);
参数说明:increment指定堆大小的变化量。
increment为正数,表示增加堆的大小。
increment为负数,表示减少堆的大小。
increment为0,返回堆当前边界值。
返回值:
成功:返回调整后的堆当前边界值。
失败:返回(void*) -1,并设置 errno 。
sbrk函数示例代码如下:
// 获取当前堆的结束地址
void* current_brk = sbrk(0);
printf("current heap end: %p\n", current_brk);

// 尝试将堆的大小增加 1024 字节
void* new_brk = sbrk(1024);
printf("new heap end: %p\n", new_brk);

// 尝试将堆的大小减少 512 字节
new_brk = sbrk(-512);
printf("new heap end: %p\n", new_brk);
3.2 聊聊ptmalloc
前面我们提到过,堆内存的使用并不简单,用户程序如果直接通操作堆内存(调用brk或sbrk函数)会存在一些潜在问题:
内存泄漏:手动分配后未释放内存,导致内存占用持续增长。
内存碎片:频繁分配/释放不同大小内存,产生不可用的小块碎片空间。
线程不安全:多线程并发操作堆内存时,竞争引发数据损坏或崩溃。
越界访问:读写超出分配区域(如数组越界),破坏相邻数据结构。
为了更好的使用堆内存,我们需要通过ptmalloc来管理堆内存。ptmalloc是一个基于glibc的动态内存分配器,用于实现malloc、free和相关函数。
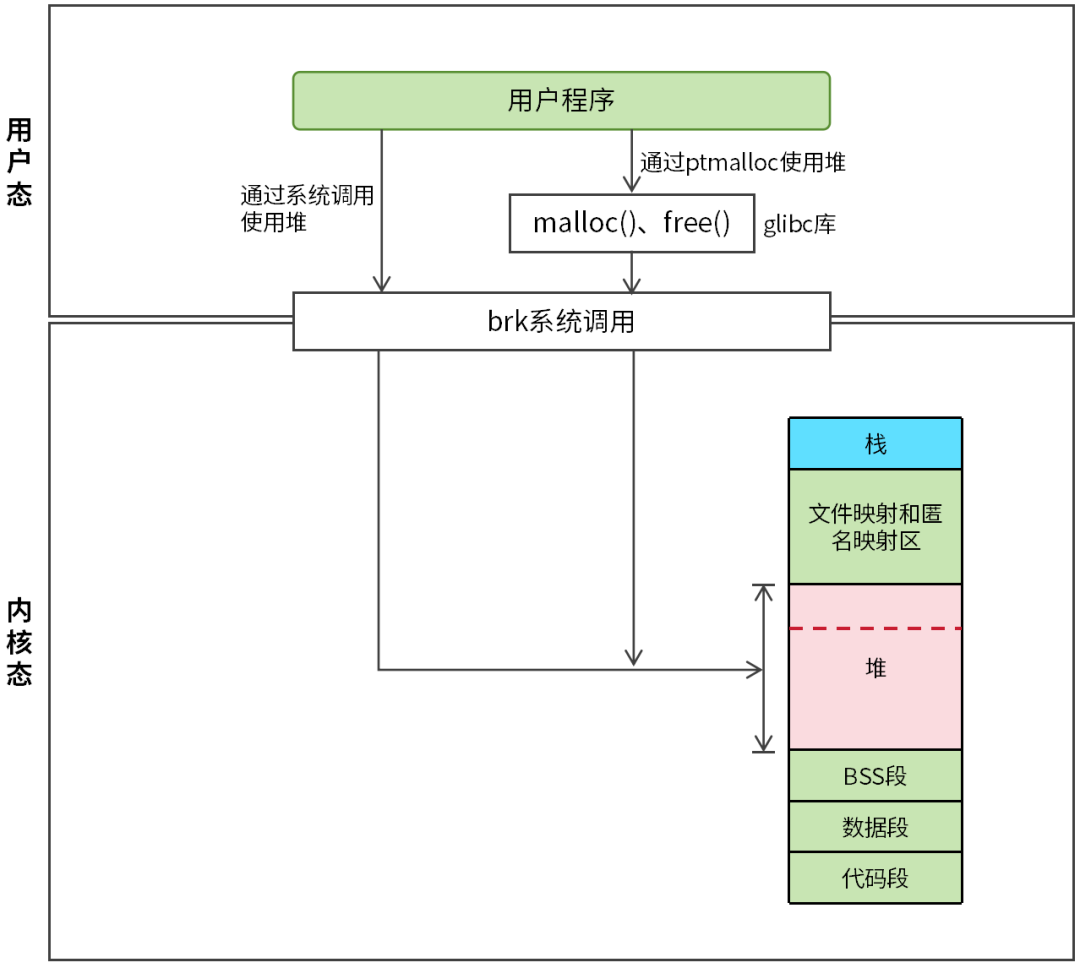
图4 ptmalloc简介
如图4所示,用户程序通过系统调用和ptmalloc两种方式操作的是同一块堆内存。如果二者混用,将会破坏ptmalloc内存池结构,导致内存错误(非法访问)。直接使用堆内存也存在种种弊端,所以最好的方式是通过动态内存分配器(如:ptmalloc、tcmalloc等)来管理堆内存。